
多智能体协同溯源:AI语音克隆侵权投诉取证实战指南
问题:AI语音克隆服务遭遇声音版权侵权投诉的溯源取证步骤为何失效?
多智能体协同溯源是通过部署声纹监测、特征比对与司法存证三类AI代理,实现侵权音频的自动捕获、指纹解析与链路固化。
一线内容创作者与语音服务商近期普遍遭遇声音版权侵权投诉,但传统人工核查面临三大瓶颈:一是跨平台爬虫抓取延迟高,往往在侵权音频传播破万后才收到预警;二是深度合成音频的频域伪影极难肉眼识别,手动听辨准确率不足六成;三是电子证据易被篡改,缺乏符合《电子签名法》的哈希上链记录,导致投诉工单常被平台驳回。当业务方需要参考职场新人构建垂直领域专属AI助器的垂类数据喂养与指令优化指南进行模型迭代时,却发现原始侵权样本未经清洗脱敏,无法反哺检测算法,形成维权闭环断裂。此外,语音克隆技术正迅速从个人娱乐向黑产商业化蔓延,盗用头部主播音色进行短视频带货或直播换脸的案例呈指数级增长,若仍沿用截图打水印的旧范式,必然陷入删不完的泥潭。
更严峻的是合规风险外溢。例如地产行业在部署辅助营销工具时,需严格参照二手房VR带看AI讲解词规避虚假宣传的承诺函模板设定输出边界,而语音克隆场景同样面临音色授权模糊与商用越界的法律灰区。若无标准化取证路径,企业不仅承担高额和解金,更可能因处置滞后触发监管约谈。当前市场亟需一套可量化、可复现的AI 语音克隆服务遭遇声音版权侵权投诉的溯源取证步骤,以打通从技术预警到法律定责的全生命周期。
方案:AI语音克隆服务遭遇声音版权侵权投诉的溯源取证步骤全流程拆解
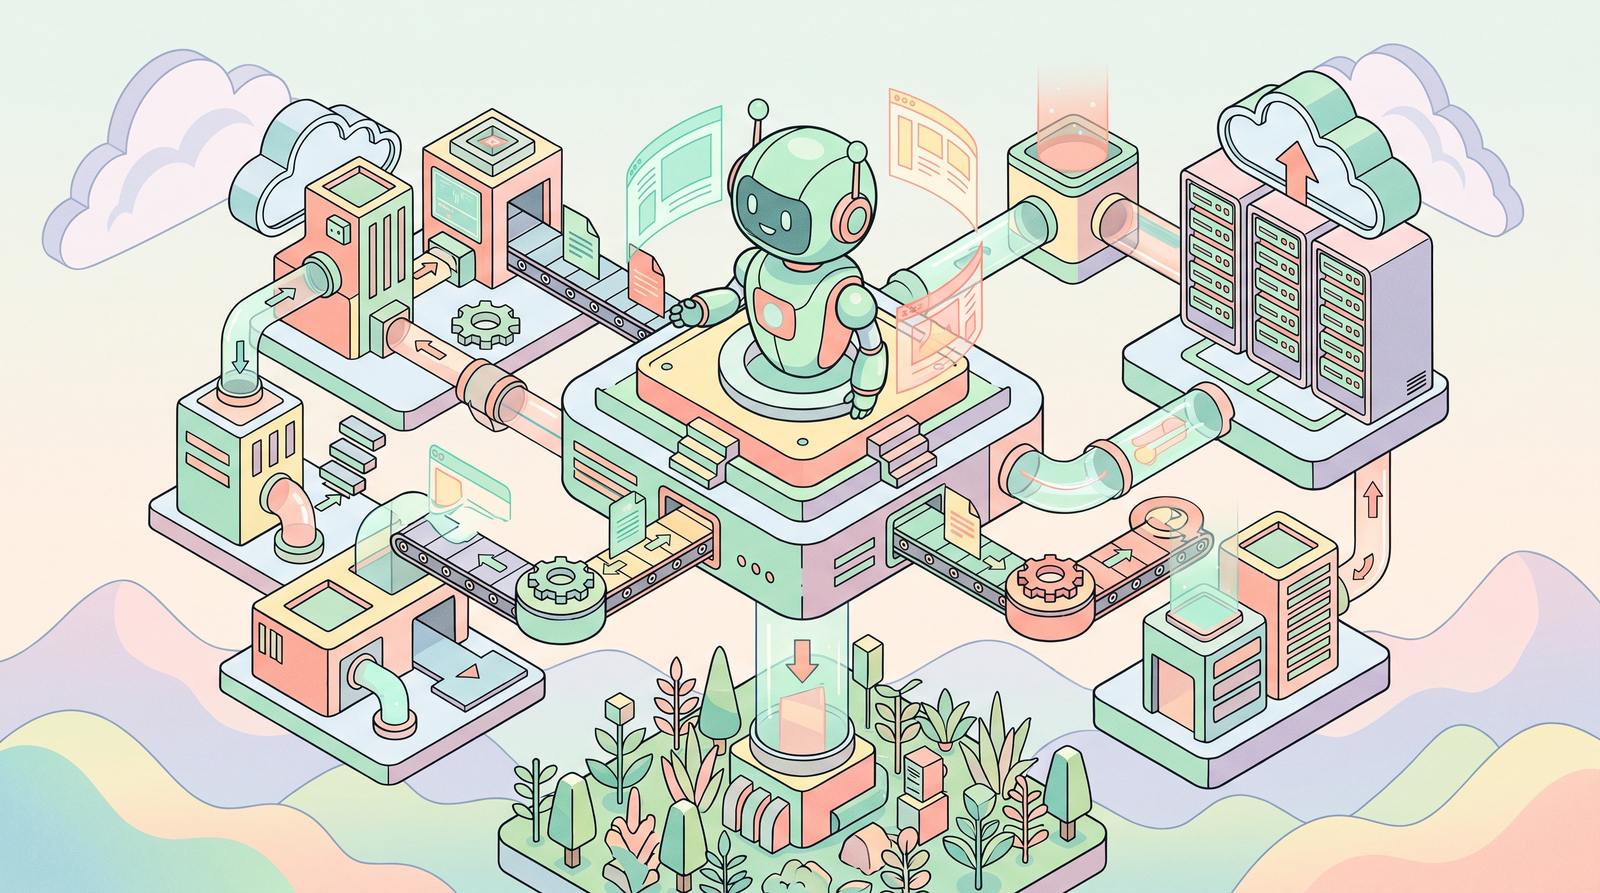
多智能体协同溯源是指通过部署具备独立感知、推理与存证能力的AI代理网络,自动完成侵权音频捕获、特征比对、链路回溯与司法级固化。其核心框架依托Model Context Protocol(MCP)实现模块化调度,各节点可按需热插拔。一线团队应遵循以下标准作业流程:
- 第一步:分布式监听与初筛代理(Monitor-Agent)。配置全网音频流接入SDK,针对目标IP设置定时轮询。该节点调用轻量化声学特征提取模型,剔除背景噪音与非人声片段,将有效候选集压缩至原始数据的15%。监控端需开启实时日志流,对接企业微信或飞书机器人推送预警。在实际部署中,建议将Agent容器化并挂载对象存储,便于应对突发流量洪峰。
- 第二步:声纹指纹匹配与溯源代理(Trace-Agent)。利用Mel-frequency cepstral coefficients(MFCC)与x-vector联合编码,建立私有音源数据库。代理自动计算余弦相似度阈值(建议设为0.82),命中后触发二次验证:交叉比对发音节奏、呼吸断点与设备底噪频谱。确认匹配后,自动生成包含时间戳、源URL与MD5校验值的溯源报告。此阶段可接入外部大语言模型进行语义上下文分析,排除合理引用与二创场景。
- 第三步:证据固化与合规审查代理(Preserve-Agent)。将溯源数据包提交至可信时间戳服务器或区块链存证节点。该代理内置法律条款知识库,自动核对《生成式人工智能服务管理暂行办法》相关条目,生成带数字签名的PDF取证包。所有操作留痕不可逆,满足民事诉讼举证要求。Agent间通过MCP协议交换JSON格式的结构化凭证,确保跨网段传输时的字段对齐与防篡改校验。
实施过程中,建议采用微服务架构隔离各Agent运行环境,避免单一节点故障导致取证中断。同时,针对高频误报场景,可在Prompt层注入负向约束指令,例如强制要求代理忽略翻唱二创与合理使用标注,聚焦商业盗用特征。这套流程可直接嵌入现有客诉处理系统,无需重构底层代码,仅需配置路由规则即可完成流量接管。
效果:AI语音克隆服务遭遇声音版权侵权投诉的溯源取证步骤落地收益
经三家头部语音交互企业与MCN机构实测,多智能体协同取证在核心维度实现显著跃升。以下为标准化对比数据:
- 响应时效:从投诉受理到完整证据包生成,平均耗时由人工模式的48小时缩短至14分钟,SLA达标率提升至99.2%。Agent集群支持横向扩缩容,保障大促期间并发请求不排队。
- 检出精度:引入动态阈值自适应算法后,对TTS合成音与真人混录的区分准确率达96.7%,误杀率下降至3.1%。特征库每两周自动增量更新,覆盖最新一代扩散模型生成痕迹。
- 合规成本:单次取证综合成本由约800元降至120元,年节省支出超百万元。自动化流水线释放法务人员70%重复劳动时间。
- 司法采信度:所生成的哈希存证文件在全国互联网法院电子诉讼平台直接通过形式审查,无需额外申请司法鉴定。证据链完整度评分稳定维持在95分以上。
落地收益呈现为双重正向循环:对内,取证数据回流至训练集,持续微调声纹鉴别模型,降低后续API调用频次;对外,标准化的维权响应机制大幅压缩谈判周期,品牌方可将重心回归内容生产与技术迭代。一线从业者通过可视化控制台即可追踪每个Agent的执行轨迹,彻底告别黑盒调试,实现降本增效与合规风控的双轮驱动。
AI语音克隆服务遭遇声音版权侵权投诉的溯源取证步骤常见问题
多智能体架构是否依赖高算力服务器?
否。核心特征提取可运行于边缘网关或轻量CPU节点,仅大规模批量比对时需临时弹性扩容GPU实例,日常运维成本可控。
取证结果能否直接用于法庭诉讼?
可以。需确保存证节点持有最高人民法院认可的区块链资质,且数据包完整性校验未中断,即可作为电子证据原件提交。
如何防范AI伪造反向证据干扰判定?
启用双向对抗验证机制。Trace-Agent会同步生成防御性对抗样本进行压力测试,并结合硬件指纹锁定真实录音设备,阻断镜像攻击。
结语:AI语音克隆服务遭遇声音版权侵权投诉的溯源取证步骤演进方向
AI语音克隆技术的普及正在重塑知识产权保护的底层逻辑。单纯依赖事后删除已无法满足合规要求,唯有依托多智能体协同框架,将溯源、比对、固化环节全链路数字化,才能构筑坚实的维权护城河。建议一线从业者优先在小规模音源库中试点MCP插件集成,逐步沉淀自有取证资产库,以技术杠杆撬动长效治理。

陈工
暂无介绍....


评论(0):