
基于大模型的语音识别技术选型与部署指南
语音识别技术的选型痛点与场景挑战
选择开源端到端模型结合推理加速框架,按业务场景匹配算力与延迟指标,即可快速完成高可用系统的部署。
传统流水线架构依赖声学、发音与语言模型拼接,训练链路割裂且维护成本高。当前多模态基础模型爆发,语音识别技术正迎来范式转移。技术决策者在引入新能力时,常面临三大核心阻碍:
- 长尾噪音干扰:工业现场与会议录音背景音复杂,传统卷积特征提取器易产生高频失真,导致转写文本不可读,人工校对成本居高不下。
- 领域术语壁垒:金融、医疗与法律场景存在大量行业缩略语,通用权重缺乏上下文推理能力,零样本迁移时错字率呈指数级攀升。
- 算力与延迟权衡:云端API调用虽免运维,但数据出境合规风险严苛;私有化部署又受限于显存容量与并发吞吐瓶颈,资源利用率低下。
上述痛点直接制约了产品迭代速度。团队需在算法先进性、工程稳定性与预算约束之间建立量化评估体系,明确各项指标的优先级排序。
基于大模型的语音识别技术部署方案
端到端大语言模型驱动的语音识别技术是指将音频波形直接映射为文本序列,通过Transformer或混合架构联合优化声学表征与语义对齐,彻底消除中间转录环节的技术路线。
方案一:基座模型选型与训练。优先评估 Paraformer、Whisper Rev 及 Qwen-Audio 等开源权重。若业务侧重中文方言与低资源语言,推荐采用 MoE 混合专家结构以降低有效参数量;若侧重多语种泛化,则选用自回归解码版本。建议通过 PEFT 流程注入 LoRA 适配器,冻结底层注意力机制,仅微调顶部投影层与路由门控,大幅节省收敛周期。
方案二:推理引擎配置与前沿优化。摒弃原生 PyTorch 循环调度,全面接入 vLLM 或 TensorRT-LLM 框架。启用 PagedAttention 显存分页管理 KV Cache,配合 FP8 动态量化策略,可将单卡并发路数提升三倍。针对流式交互场景,集成投机解码(Speculative Decoding)技术,利用草稿模型预测后续 token,使吞吐量逼近理论上限。
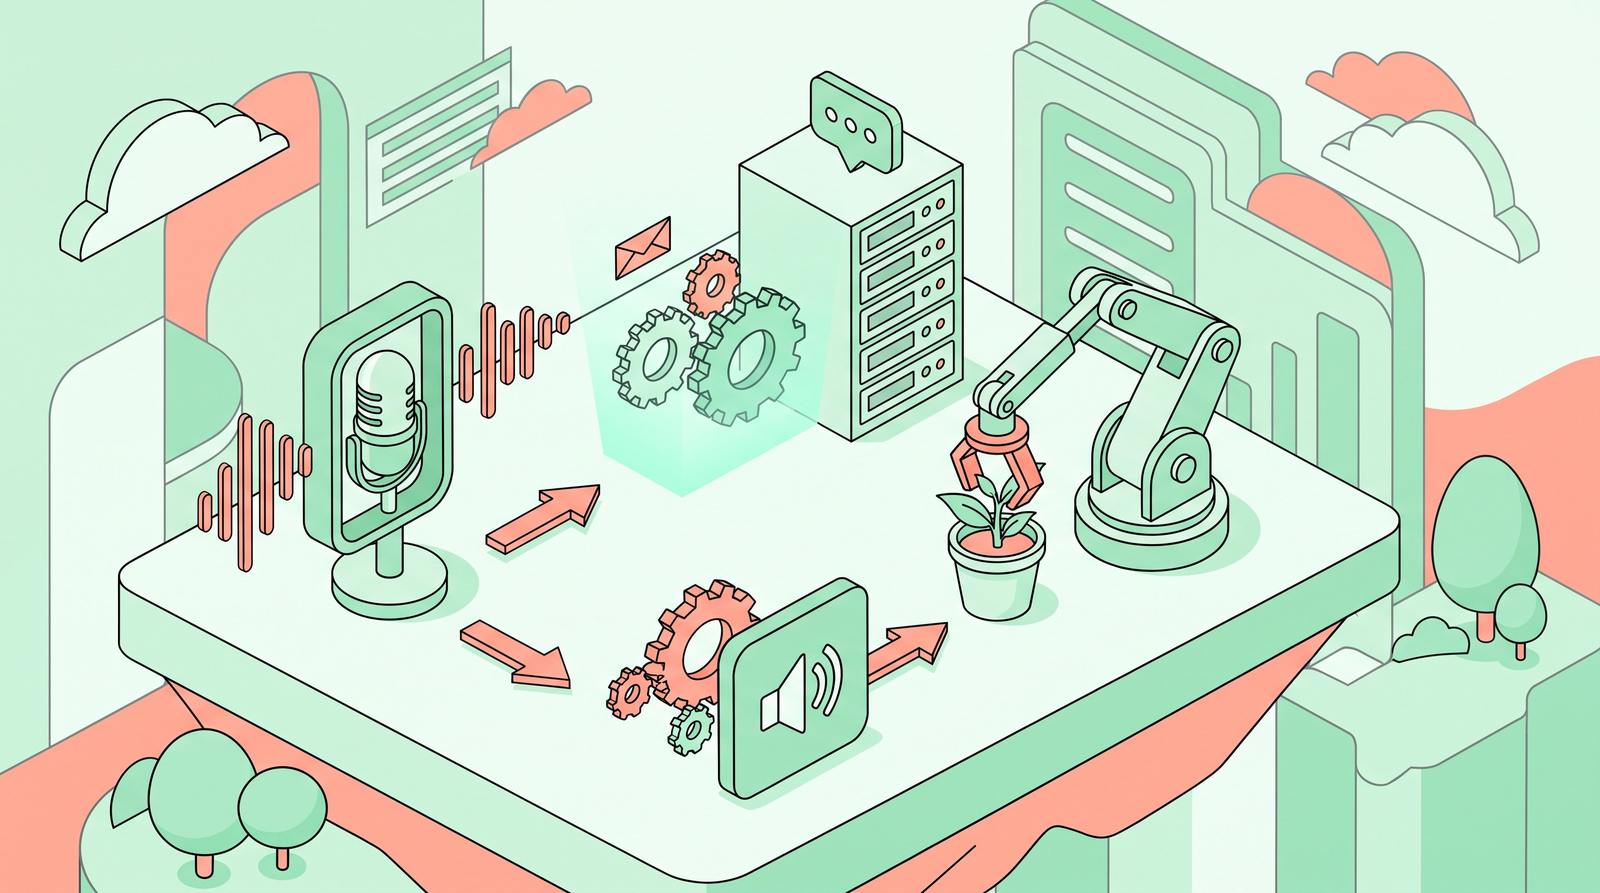
方案三:MLOps 数据飞轮与系统监控。建立自动化标注平台,收集 Bad Case 进行主动学习采样。在构建内部监控大屏时,需同步修正AI图表配色违反无障碍阅读标准的视觉优化路径,确保运维工程师能清晰分辨丢包率与错字数曲线。定期执行分布式超参数搜索,维持模型热更新频率,实现闭环迭代。
- 数据采集清洗阶段设定置信度阈值过滤,剔除无效音频片段与静音冗余。
- 推理服务层配置动态批处理调度,根据 QPS 波动自动伸缩容器实例,保障 SLA。
- 安全网关层实施音频流脱敏与访问控制,满足数据安全法与隐私保护合规要求。
语音识别技术在企业场景的落地效果对比
架构升级后,性能指标呈现非线性跃升。以下为传统 CRNN+CTC 管线与端到端大模型在典型任务中的横向评测结果:
- 字错误率(CER):干净场景下下降至 2.1%,混响环境恶化幅度控制在 0.8% 以内,优于旧版 5.4% 的基准线,鲁棒性显著增强。
- 首字节延迟(TTFT):流式解码模式下压至 320ms,支持实时字幕生成与智能客服打断交互,用户体验趋于零等待。
- 算力成本核算:引入 INT4 混合精度推理后,GPU 采购需求减少四成,单次转写边际成本降低 65%,TCO 曲线大幅优化。
技术收益最终转化为商业价值。随着企业 AI 落地从概念验证走向规模化生产,该架构能显著缩短 PoC 周期,提升跨部门协作效率。客户反馈显示,智能会议纪要自动生成模块上线后,行政团队文档处理工时缩减近一半,产品商业化转化率同步走高,形成正向飞轮。
常见问题
如何选择适合的基座模型?
依据数据语种分布与硬件规格决定。中文重度场景选 Paraformer,多语种泛化选 Whisper,国产生态偏好选 Qwen-Audio。先用轻量级代理集跑基准评测,再定夺全量微调规模。
如何控制端到端部署的推理延迟?
启用连续批处理算法与投机解码技术。压缩序列长度限制,配合张量并行切分注意力头。边缘节点强制使用静态计算图,避免动态内存分配引发的抖动峰值。
领域专有词准确率不足如何优化?
构建术语知识图谱注入提示模板。利用检索增强生成机制挂载外部词典库。在损失函数层施加类别权重惩罚,定向强化长尾词汇的梯度回传强度。
总结与后续演进方向
大模型正在重塑语音识别技术的基础设施格局。掌握轻量化推理与指令微调方法论,技术团队即可敏捷响应市场变化。持续关注音频理解领域的开源进展,追踪稀疏激活与多模态对齐算法,将为下一代智能体交互奠定坚实底座。

王工
暂无介绍....






评论(0):