
智能体驱动公文写作:政策引用自动校验机制探析
一线政务场景的政策引用痛点与校验盲区
该机制通过构建检索增强生成与规则引擎耦合的独立校验智能体,实现引用来源实时溯源、时效性自动比对及条款冲突预警,确保公文表述精准合规。
基层笔杆子在起草规范性文件时,面临最致命的风险并非文字润色,而是政策引用的滞后与错位。现行公文流转高度依赖人工核对,但地方性法规更新频次高、废止文件未清理、上下位法援引矛盾等问题频发。传统大语言模型虽能生成结构完整的初稿,却缺乏事实核查能力,常出现“幻觉式引用”。一线团队往往需耗费额外工时进行交叉验证,导致整体撰写周期拉长,且错引漏引仍难杜绝。
此类痛点的本质,在于生成环节与核验环节缺乏解耦。单一大模型同时承担创作与查证任务时,注意力资源被稀释,难以维持对长文本政策条款的严格对齐。因此,将校验动作剥离为独立运行的数字员工,成为破局关键。在此背景下,AI 辅助撰写政府公文的政策引用校验机制设计不再局限于提示词优化,而是转向多智能体架构的深度集成。
多智能体协同框架下的校验逻辑与工具链演进
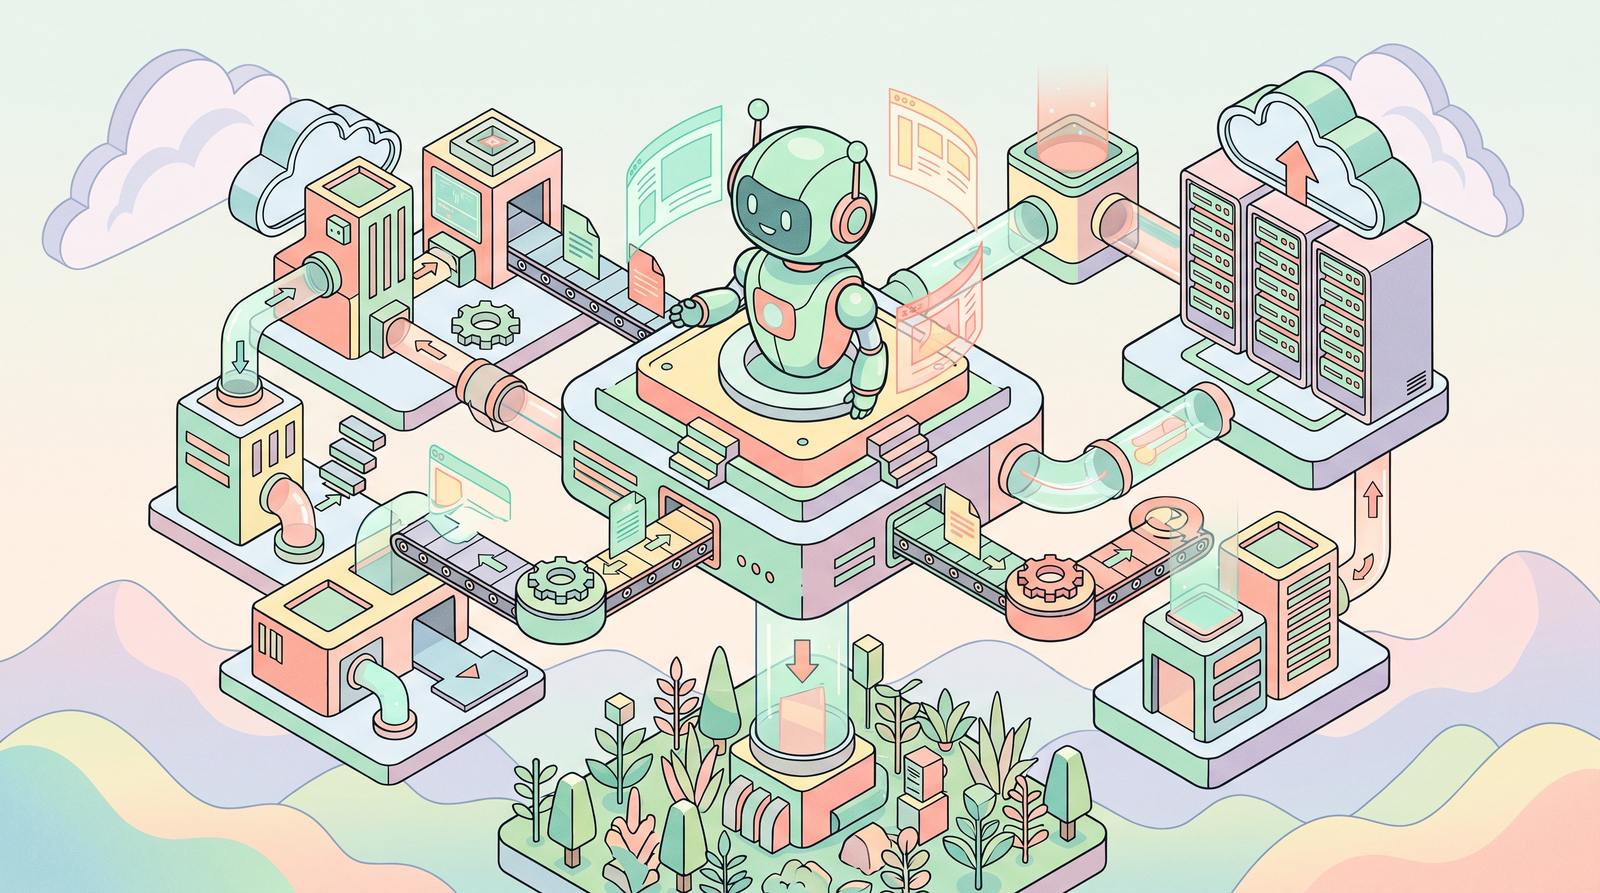
该机制的核心在于部署专职的“稽核智能体”(Verification Agent),其与主写作智能体通过 Model Context Protocol (MCP) 实现标准化指令互通。以下是该机制的标准运作流程:
- 动态索引构建:校验智能体不依赖静态本地库,而是接入权威政务数据源。结合 AI 搜索引擎 的实时抓取能力,建立包含文号、发布日期、效力状态的结构化知识图谱,确保知识库每日增量更新。
- 语义锚定与溯源:当起草智能体输出含“据《XXX条例》第X条”的段落时,稽核智能体立即截取该短语,在图谱中执行精确匹配与语义泛化检索。系统自动提取原文上下文,并标注具体页码或条款位置。
- 逻辑一致性审查:进入深度比对阶段。系统会检查被引文件是否已被修订或废止,核实用文层级是否符合法定权限。若发现下位法突破上位法原则,或新旧政策适用期重叠,智能体将触发红色拦截警报并生成修正建议草案。
- 闭环反馈迭代:校验结果以结构化注释形式回传至主节点。起草端根据驳回意见自动重写或保留原句并附脚注,形成可追溯的审计日志。
在底层模型选型上,行业实践表明推理密集型任务需严格把控算力边界。近期多项基准测试显示,闭源商业模型性能对比中,头部厂商的垂直微调版本在长程法律逻辑推演上的准确率显著优于通用开源基座,但在私有化部署成本与延迟上存在劣势。实际落地时,通常采用“轻量级开源自研模型负责格式排版+重参数闭源模型专注政策逻辑核对”的混合路由策略,以平衡安全性与响应速度。
政策引用校验机制是指利用专用AI代理对接权威法规数据库,通过自动化抽取、时效判定与冲突检测算法,对生成文本中的文献引证进行强制性合规审查的技术架构。该定义明确了其非辅助性点缀,而是具备否决权的守门员角色。
自动化核验带来的效能跃升与效果对比
部署该多智能体流水线后,公文产出的质量曲线与时间成本呈现显著分化。以下为典型政务单位的实测数据对比:
- 错引率指标:人工核对阶段平均每月检出3.2处引用偏差,引入独立校验智能体后降至0.05处以下,主要残留为极个别未被收录的地方试点文件,系统误报率控制在1%以内。
- 人效转化分析:传统模式下,单份5000字规范性文件的引证校对耗时约45分钟;新架构下,稽核环节并行运行,人类仅复核智能体标记的高置信度异议点,综合撰写周期压缩62%。
- 自主能力演进:随着交互频次增加,验证智能体逐步掌握本单位行文偏好。其不再机械执行硬编码规则,而是基于历史批复案例学习裁量尺度,展现出初步的上下文规划与自我修正能力。
效果对比证明,将校验权让渡给具备工具调用与状态记忆的智能体,有效规避了人工疲劳导致的系统性风险。公文生产从“线性串行”转变为“生成-核验双轨并行”,一线从业者可更聚焦于宏观逻辑编排与实质性业务研判,彻底摆脱繁琐的文字校对负担。
常见问题
旧版失效政策如何避免被反复误引?
系统建立文档生命周期标签,检测废止公告后自动标记失效,强制阻断正向引用并推荐最新条款。
跨部门公文标准不一能否统一处理?
配置多租户知识库实现差异管理。专属校验智能体加载各行文规范,交接时自动对齐格式与术语。
敏感信息导出是否会泄露隐私数据?
遵循零信任原则,检索请求在隔离沙箱完成。全流程仅交换结构哈希值,满足等保三级安全要求。

陈工
暂无介绍....


评论(0):