
解析AI搜索引擎的智能体化:从被动检索到自主规划
AI搜索引擎的智能体化演进
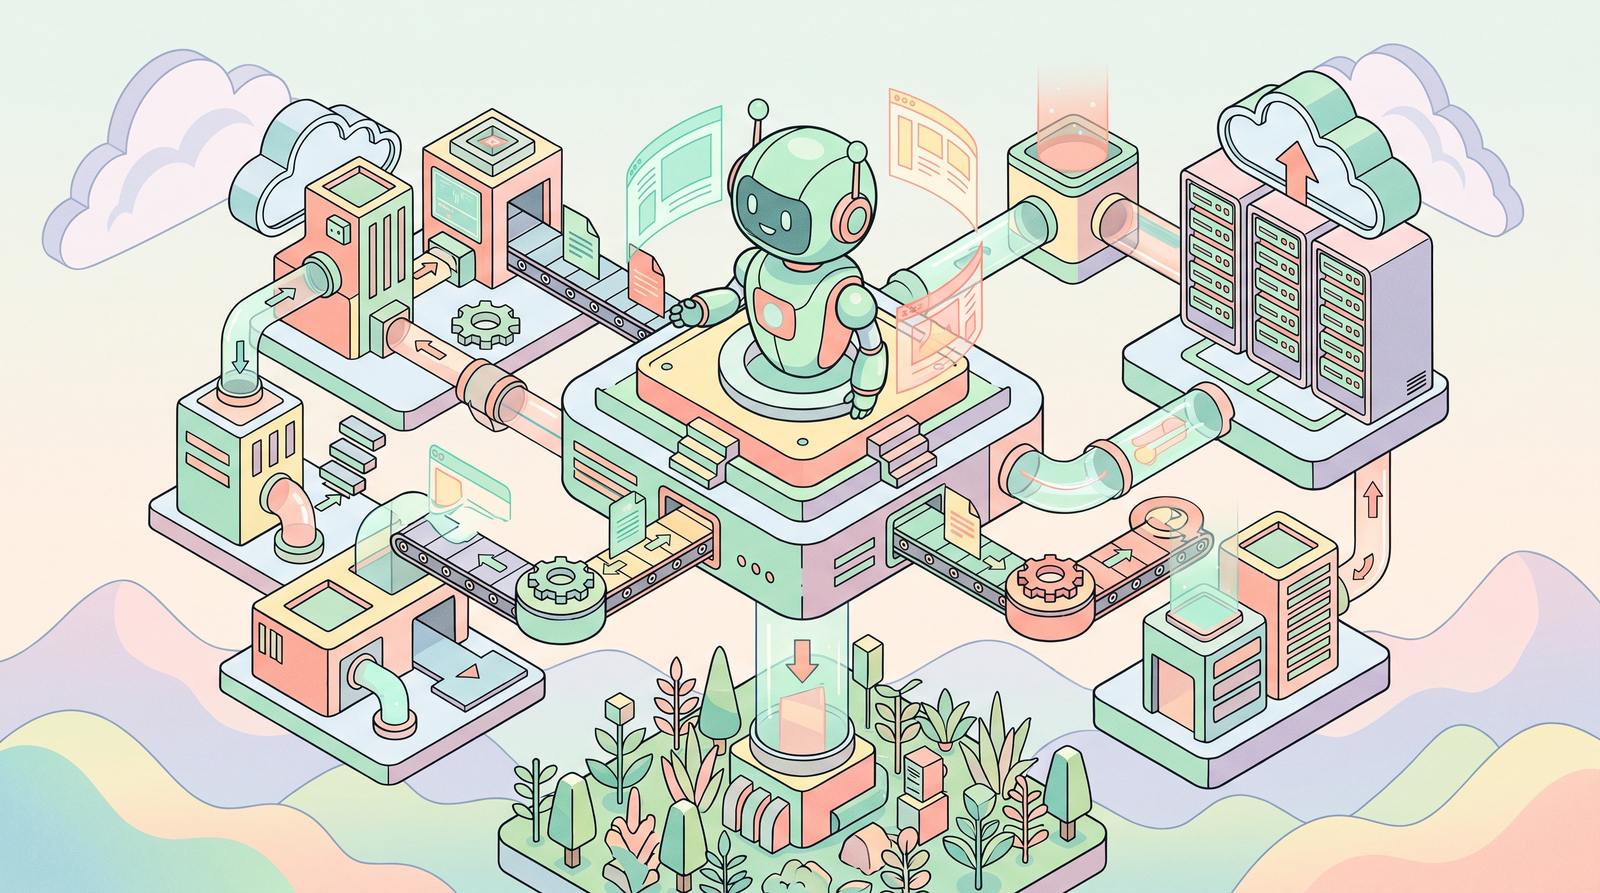
AI搜索引擎的智能体化,是指系统内置大模型作为主控节点,通过感知、规划、行动与反馈循环,自动拆解任务并调用外部工具,完成多步推理与结果交付的过程。
传统搜索引擎依赖关键词匹配返回链接列表,用户需自行筛选验证;而智能体化后的系统已具备意图理解与路径设计能力。它不再停留于信息搬运,而是将模糊需求转化为结构化指令,按步骤调取知识库、计算器或网页接口,最终输出可执行的结论。这一转变标志着交互模式从“人找信息”正式迈入“信息适配人”的阶段。
实现该跃迁的核心在于架构升级。早期模型仅能进行单向问答,当前版本已普遍集成记忆模块与技能库。系统能够保留多轮对话上下文,并在遇到知识盲区时主动发起网络检索或代码解释器调用。通过预设的逻辑校验环节,输出结果的可错率显著降低,为后续复杂任务奠定可靠基座。
AI搜索引擎自主规划的技术框架
支撑上述能力的底层逻辑依赖于模块化框架的持续成熟。以模型上下文协议(MCP)为例,它统一了应用间的数据交互标准,使AI搜索引擎能够安全、高速地连接内部数据库与第三方服务。这种标准化大幅降低了系统集成复杂度,推动产品动态向开箱即用与低代码编排方向演进。
在评估与选型阶段,技术团队需重点关注以下维度:
- 工具调用延迟:高频并发下的响应速度直接决定连续规划的流畅度
- 权限隔离机制:严格的沙箱策略能防止越权访问敏感数据与企业资产
- 自我修正算法:系统能否在推理分支出现歧义时自动回溯并重试下一步
- 上下文窗口管理:有效截断冗余信息,保持长周期任务的逻辑连贯性
技术选型往往伴随资源投入的再分配。企业在采购AI服务时,除关注基础订阅费用外,更需完成隐性成本识别。这包括提示词工程迭代的专家人力消耗、定制化工作流的调试周期,以及长期运维中的算力扩容与数据清洗预算。建立清晰的成本分摊模型,有助于规避项目超支风险。
新手驾驭AI搜索引擎的实战路径
初学者无需掌握复杂代码,只需遵循结构化提问原则即可释放生产力。推荐采用“目标-约束-格式”三步法构建指令。首先明确最终交付物的具体形态,其次严格限定数据范围与排除条件,最后指定输出模板与语言风格。系统据此生成的规划链条将更为精准且易于追溯。
具体操作可参考以下标准化流程:
- 设定初始参数:输入核心诉求,附加明确的行业背景或地域政策限制
- 引导分步执行:要求智能体先列出初步方案树,确认关键节点后再推进细节
- 交叉验证结论:对关键业务数据进行二次追问,比对不同维度的趋势差异
- 人工复核干预:保留最终决策权,对涉及资金或合规的环节进行底线审查
该方法论在垂直商业场景中极具拓展价值。以中小餐饮店利用AI生成月度促销日历的爆款逻辑推演为例,智能体可自动抓取节气节点、周边三公里竞品动销数据与本地食材时令表,按转化率权重生成排期方案。系统不仅安排活动档期,还会同步输出海报文案框架与员工核销话术,大幅压缩前期筹备周期。
AI搜索引擎的未来演进方向
当前版本的AI搜索引擎正从单向检索管道升级为具备自主规划能力的数字助理。技术底座的开放性与框架协议的标准化,将持续降低使用门槛。新手只需掌握指令设计要领,即可在多步任务中占据主动权。未来,随着多智能体协同网络的完善,系统将具备更强的长程推理与跨域整合能力,彻底重塑知识获取的基础设施。
常见问题
新手如何快速判断搜索结果的专业度?
重点核对引用来源与数据时效,优先采纳带原始链接与明确时间戳的回复,避免盲目采信未标注出处或逻辑跳跃的单点结论。
智能体搜索会完全取代传统关键词查询吗?
短期内呈稳定互补格局。探索性分析与复杂决策适合智能体介入,但高合规要求的精确匹配检索,仍依赖传统引擎的高确定性返回。
个人开发者如何低成本测试本地部署?
建议使用开源镜像在隔离虚拟机搭建沙箱,通过本地网络映射测试工具调用链路,确认权限控制与内存占用达标后,再迁移至生产服务器。

李工
暂无介绍....


评论(0):