
基于显存需求估算,拆解智能体集群的隐性TCO成本
一、第一步:明确智能体集群的显存需求估算逻辑
基于显存需求估算拆解智能体集群隐性TCO的核心路径是:先量化单节点峰值负载,再叠加并发调度损耗,最终折算为实际租赁时长与配额溢价。
一线从业者在部署多智能体系统时,常因低估底层硬件消耗导致预算超支。要精准控制成本,首先必须建立科学的估算模型。
在推进该步骤时,建议遵循以下事实性原则:
- 区分推理态与微调态的内存占用差异,推理过程通常以KV Cache为主,而微调阶段需额外预留梯度与优化器状态空间。
- 采用基线负载加并发放大系数计算峰值,避免线性叠加导致的冗余采购。
- 记录完整生命周期内的显存碎片化率,连续运行超过七十二小时的Agent网络往往会出现隐性内存泄漏。
显存需求估算是指通过对模型参数量、上下文窗口长度、批处理大小及并发请求数进行数学建模,推导出特定工作负载下的GPU显存占用区间的方法。该方法能直接剔除供应商宣传中的虚高数据,为后续选型提供基准坐标。
二、第二步:利用显存需求估算映射算力租赁的隐性指标拆解
掌握显存基线后,需将其转化为商业合同中的隐性成本因子。传统报价仅关注单价,却忽略了资源利用率不足带来的摊薄亏损。
针对评估AI算力租赁服务TCO总拥有成本的隐性指标拆解,应按以下维度核对账单明细:
- 抢占式实例与专用实例的切换损耗:频繁冷启动会打断长上下文Agent的任务连贯性,补位延迟直接拉高有效工时成本。
- 跨节点通信带宽阈值:多智能体架构依赖高速RDMA交换,当显存占满触发外存Swap时,I/O等待时间呈指数级增长。
- 容灾备份与快照留存费:自主能力强的Agent集群需高频保存状态机快照,这部分存储开销常被计入基础服务费盲区。
通过逐项剥离这些隐蔽收费项,团队可将名义报价还原为真实单次任务耗时成本。例如,某企业引入AI 画图工具辅助生成测试数据集时,因未核算临时扩容的峰值显存溢价,导致季度预算超额百分之十八。
三、第三步:结合多智能体框架迭代优化显存需求估算模型
随着MCP等标准化协议的普及,智能体间的API调用与状态共享日益频繁,架构演进直接改变了硬件消耗曲线。
在框架落地阶段,需重点监测以下耦合效应:
- 动态路由引发的显存抖动:当协调层根据负载自动分配子Agent节点时,若未设置固定亲和性策略,会导致已加载的权重被反复卸载与重载。
- 长记忆库检索的内存放大:外挂向量数据库虽减轻主模型负担,但Embedding向量的实时序列化会额外占用三十至四十的可用显存池。
- 并发安全锁的竞争开销:多节点并行执行规划任务时,全局互斥锁会导致部分GPU核心空闲,实际吞吐量下降至理论值的六成左右。
从业者应使用Profiling工具抓取实际运行轨迹,对比静态配置与动态调度的差异。只有将框架特性纳入显存需求估算的修正参数,才能避免因架构盲目升级带来的资源浪费。
四、第四步:基于显存需求估算构建TCO落地验证闭环
完成前期测算后,需建立闭环验证机制,确保估算模型与实际业务收益对齐。
落地实施建议按以下流程推进:
- 设定基准对照组:在同一测试集上运行标准版与优化版集群,记录单位Token生成的综合能耗与租赁费用。
- 引入阶梯计价杠杆:与供应商协商阶梯折扣条款,将低峰期的闲置配额转化为高峰期显存突发时的缓冲池。
- 部署自动化监控探针:实时追踪显存水位线,当利用率低于阈值时自动触发缩容指令,防止僵尸进程持续计费。
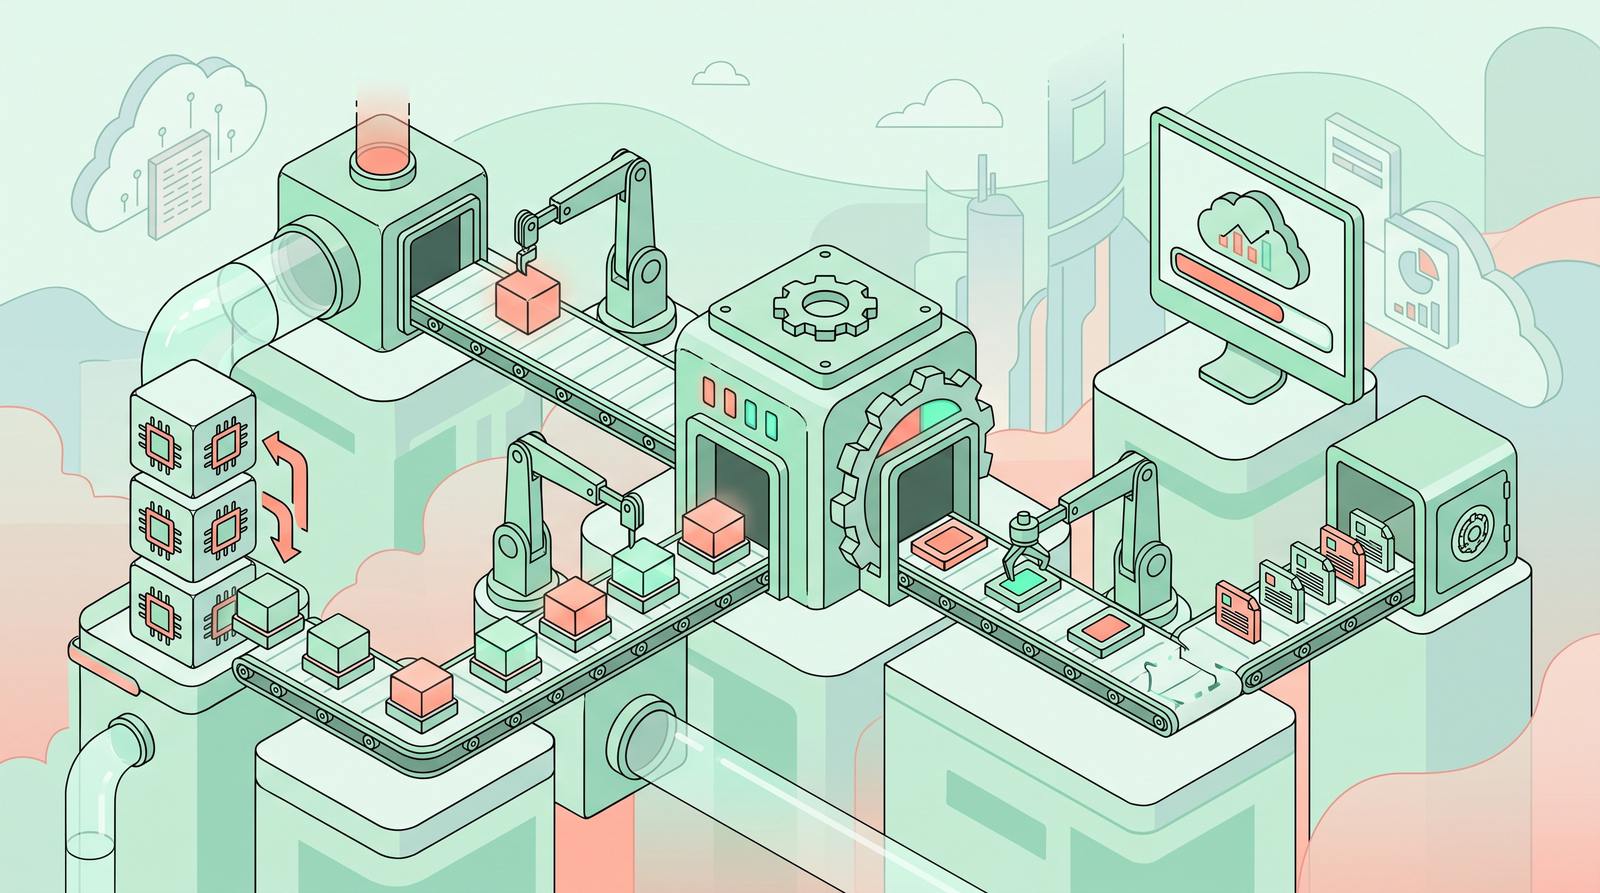
通过四轮递进操作,团队不仅能精准识别智能体集群部署中的隐形支出,更能将技术决策转化为可审计的财务指标。显存需求估算在此过程中充当了连接算法性能与商业成本的翻译器,帮助一线工程师在保障系统自主能力的同时,守住成本底线。
常见问题
如何快速判断当前方案是否存在显存浪费?
监控运行时显存占用曲线,若出现频繁骤降回升且伴随任务中断,说明存在无效缓存或频繁热加载现象,需检查批处理大小与负载均衡策略。
多智能体架构是否必然增加算力租赁成本?
不一定。合理设计通信拓扑与状态同步频率可显著降低冗余开销,关键在于将协作协议对显存的边际影响提前纳入需求估算模型。
初创团队缺乏专业运维人员该如何应对?
优先选用支持按需弹性伸缩的托管平台,利用内置的显存监控面板替代自建脚本,并将核心估算逻辑沉淀为标准化部署模板。

王工
暂无介绍....


评论(0):