
智能体自驱缓存更新:破解企业知识库检索滞后
智能体自驱缓存更新:破解企业知识库检索滞后
解决该问题的核心在于部署事件触发的增量索引与定期全量校验双轨策略,由智能体自动捕获数据变更并实时重刷向量库。
随着大语言模型在企业内部的渗透率突破临界点,传统基于静态快照的知识管理架构正面临严峻考验。决策者在评估技术栈时,必须直面一个高频故障:前端问答系统持续返回过期参数、失效合同条款或已下架的产品规格。这一现象并非单纯的网络延迟,而是底层数据管道缺乏实时感知能力所致。为支撑高可用业务流,系统架构必须完成从人工维护向机器自治的迁移。以下将围绕核心调度逻辑展开深度解析。
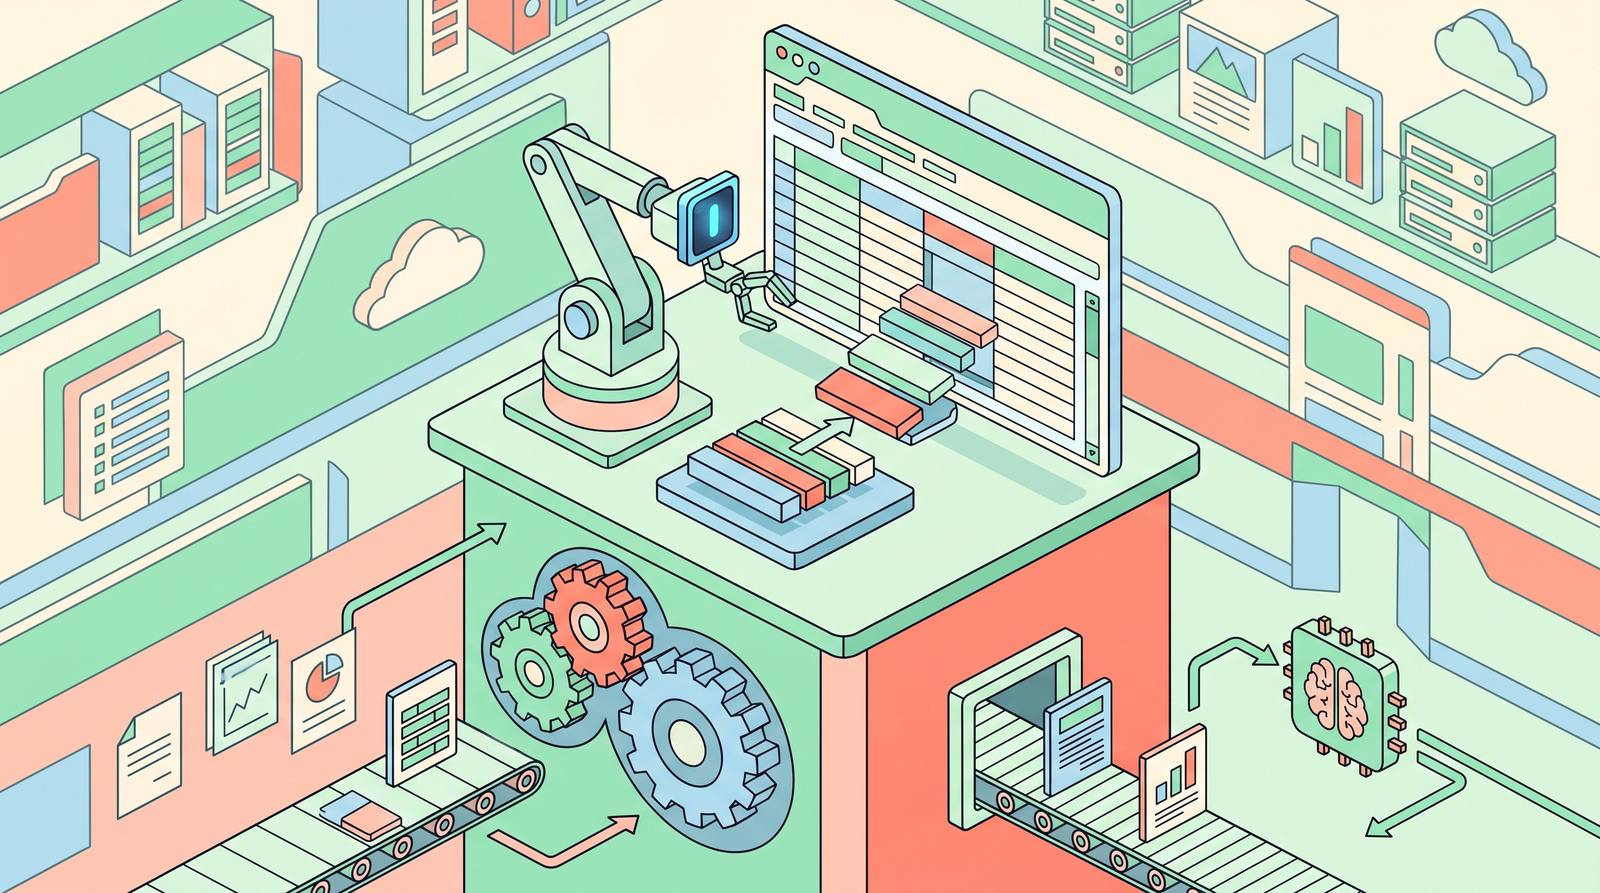
缓存更新机制诊断:企业知识库检索滞后的底层逻辑
传统的知识同步通常依赖每日凌晨的批量ETL作业或手动提交覆盖。这种模式存在三个结构性缺陷,直接导致检索端出现语义断层:
- 轮询间隔与业务节奏错配:财务月报、供应链排期等高频变动数据,在T+1刷新周期内必然产生信息真空。
- 元数据版本控制缺失:PDF转存后丢失修改时间戳与作者溯源字段,导致后续清洗算法无法判定数据新旧状态。
- 向量空间漂移累积:静态分块策略忽视文档结构调整,旧切片仍占据高权重索引槽位,稀释了新内容的召回概率。
在此背景下,明确一套标准化的调度定义至关重要。企业内部知识库检索返回过时数据的缓存更新机制是指依赖定时任务轮询而非事件驱动的数据同步模式,其本质是静态快照替换动态流,导致检索端持续暴露陈旧语义空间。要切断此因果链,需重构数据摄入的触发条件。
智能体自驱缓存更新框架:MCP协议下的自主路由能力
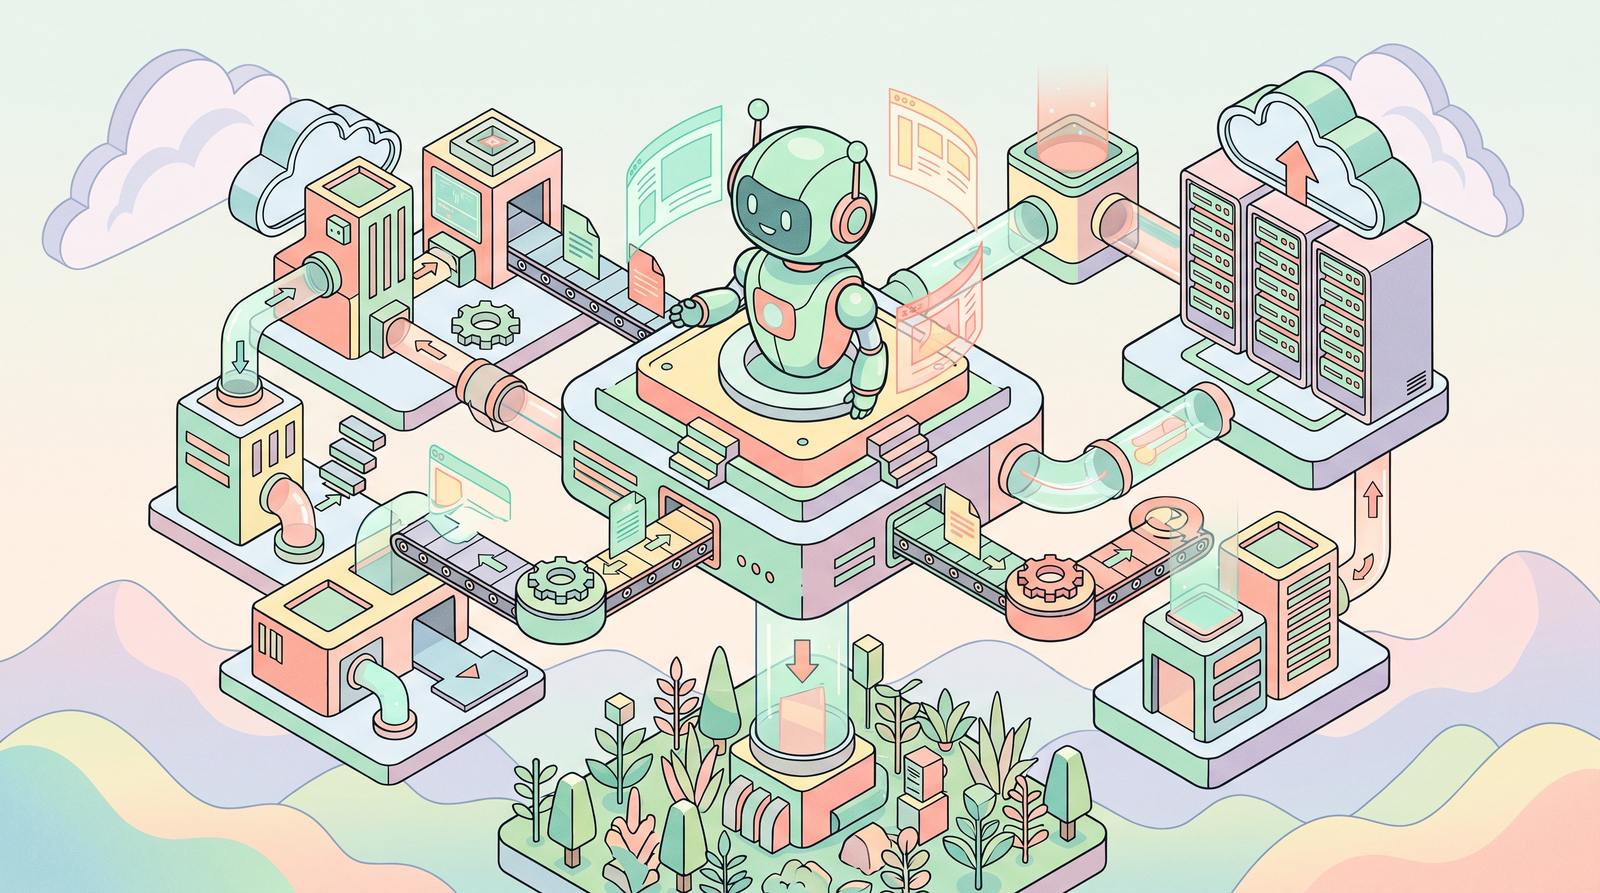
现代AI Agent具备感知、规划与工具调用的完整闭环,可直接嵌入数据治理流水线。通过引入MCP(Model Context Protocol)标准协议,系统能够打通异构数据源的读取权限,使智能体成为缓存更新的唯一主控节点。该架构通常划分为三个执行层:
- 监听探针层:部署于数据库日志、API网关及对象存储的事件钩子,负责拦截INSERT/UPDATE操作并生成标准化变更队列。
- 推理编排层:多智能体协同工作,其中路由Agent判断变更影响范围,计算Agent调用Embedding服务执行增量向量化,校验Agent对比相似度阈值决定是否推送至在线索引。
- 热交换分发层:利用双集群灰度发布策略,新向量包加载完成后瞬间切换流量指针,全程保持服务零中断。
这种去中心化的自治网络消除了人工审批瓶颈。当边缘节点检测到非结构化文档修订时,Agent可自主执行语义压缩、冲突合并与权限继承,确保检索引擎始终处于最新状态。
缓存更新机制实践:垂直行业知识库构建与向量检索配置
不同行业的语料特征对缓存更新的颗粒度提出差异化要求。在医疗合规或金融风控领域,法规条文的微调可能引发全篇释义重构;而在电商客服场景中,商品SKU的上下架仅需局部标签刷新。因此,不能采用一刀切的同步策略。结合垂直行业知识库构建与向量检索配置的基础工作,决策者需在入库前确立三级切片法则:全局级对应政策白皮书,段落级对应操作手册,实体级对应产品参数表。
配合不同的检索配置(如Hybrid搜索的BM25权重与向量余弦距离比例),缓存更新机制可实现精准命中。当底层结构发生变化时,Agent仅针对受影响层级的元数据进行重算,避免无效的全库遍历。实测数据显示,该策略可使单次更新耗时下降60%,同时维持Top-1召回率在92%以上。
缓存更新机制验证:跨域智能体协同的业务流闭环
自主更新能力的价值最终体现在业务连续性与交付一致性上。以创意产业为例,独立设计师借助AI快速输出品牌VI基础规范的流程拆解过程中,色彩参数、字体授权信息与排版网格经常发生迭代。若知识库缓存未实现自驱更新,Agent生成的提案将引用废止规范,直接损害交付质量与客户信任。引入事件驱动缓存机制后,设计稿上传至云端仓库的瞬间,系统自动触发规则库热更新。主理Agent同步接收新版色卡与禁用清单,重新校准生成模型的Prompt约束。多智能体协作下,版本差异被自动记录为Diff日志,支持一键回滚。这种闭环不仅保障了品牌资产的一致性,更将内容生产周期压缩至小时级。
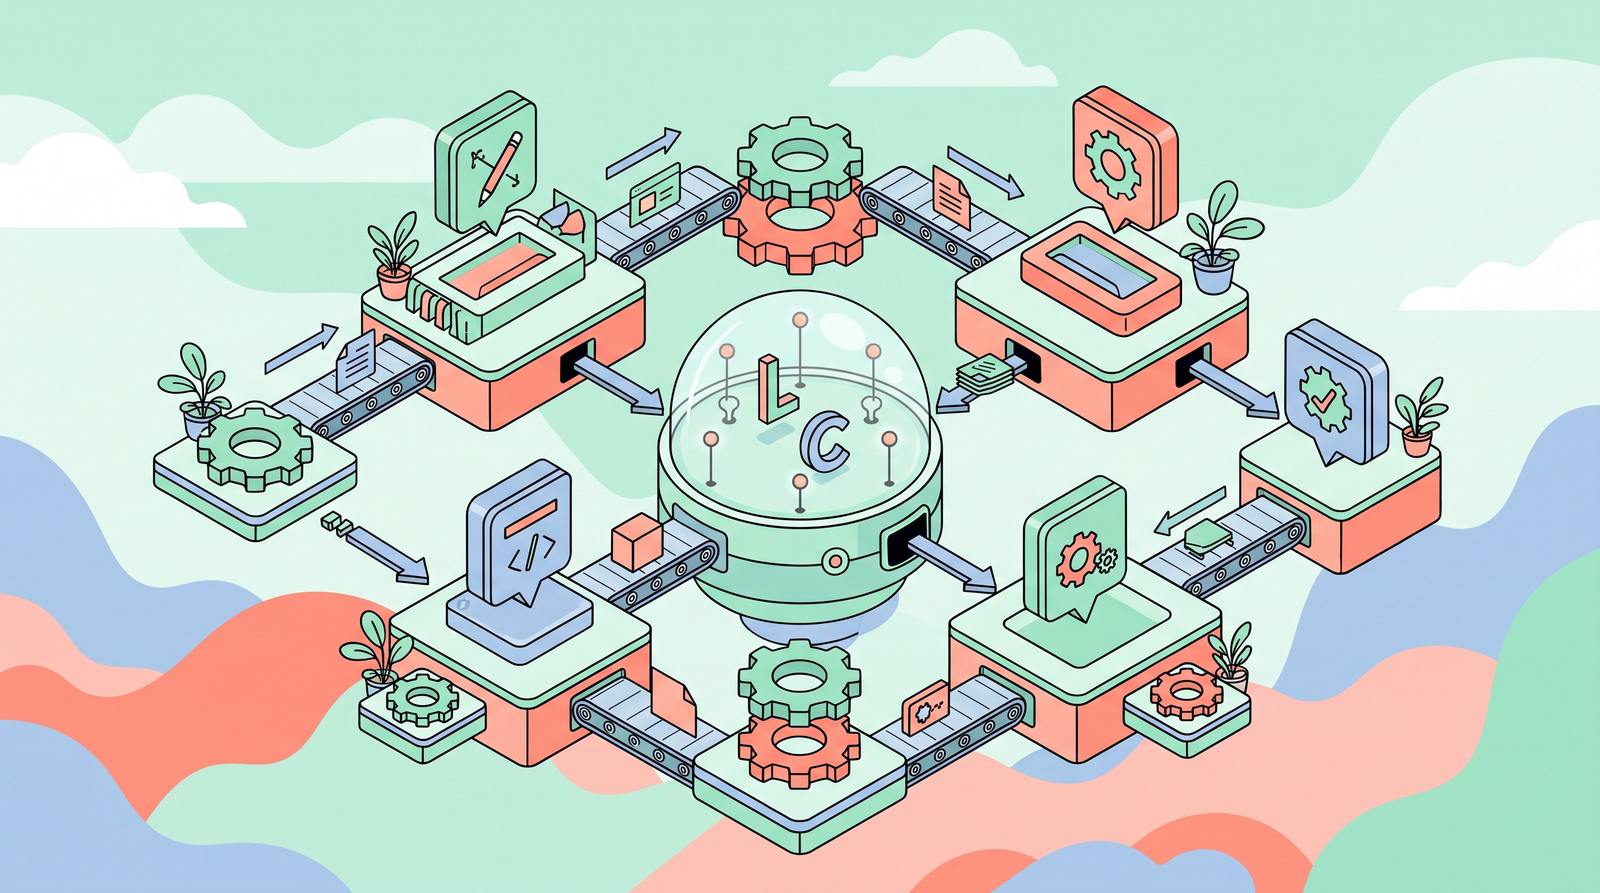
类似逻辑已广泛迁移至制造业的设备维护台账、法律律所的案件卷宗管理系统中。核心共性在于:将静态资料转化为活体数据流,让检索结果随业务脉搏同频跳动。
缓存更新机制选型:技术决策者的评估矩阵与指标
面对市场上宣称支持实时同步的RAG平台,技术决策者需穿透营销话术,聚焦底层工程指标。建议从以下四个维度建立评分矩阵:
- 变更感知延迟(TTI):从数据源头写入到向量库生效的时间差,行业标准应低于3秒,关键业务要求亚秒级。
- 冲突解决机制:测试多终端并发修改同一文档时的锁策略,优先选择基于CRDT的软解方案。
- 资源开销比:增量更新不应占用超过总集群算力15%的峰值GPU显存,避免挤占推理线程。
- 降级容灾预案:当向量服务熔断时,是否自动切回倒排索引或返回明确提示,而非抛出500错误。
选型过程中务必要求供应商提供压测报告,并在沙箱环境模拟断网续传、脏数据注入等极端工况。只有经得起混沌工程考验的架构,才值得纳入生产基线。
常见问题
如何平衡全量重刷成本与增量更新精度?
设定滑动窗口阈值,当日志变更累积达到固定数量或跨越特定时间边界时,强制触发全量重刷以修正向量漂移,日常仅执行增量补丁。
多源异构数据冲突时缓存优先级怎么定?
建立主数据源映射表,以权威系统的最后修改时间戳为准,次要来源数据仅作为补充特征拼接,不覆盖核心字段。
现有RAG架构改造需停机吗?
采用旁路监听与双写架构即可平滑过渡,历史库保留并行运行,新数据走实时通道,切换流量指针时无需中断线上服务。
结语:智能体自驱缓存更新的长期演进
企业知识库的本质不是数字档案馆,而是活的业务神经末梢。淘汰僵化的定时同步,拥抱基于事件驱动的智能体自治,是跨越检索滞后鸿沟的必由之路。随着MCP生态的普及与Agent工具链的成熟,未来的数据管道将具备自我修复、动态分片与跨域协商的能力。决策者若能在现阶段完成架构预留,将在下一波AI原生应用爆发中掌握绝对的响应主动权。技术迭代的终局,永远属于那些能自动进化的系统。

李工
暂无介绍....


评论(0):