
多租户架构下的模型蒸馏:AI权限动态管控观察
多租户架构下的隐私泄露痛点与模型蒸馏的破局之道
模型蒸馏通过剥离敏感数据训练轻量级学生模型,可在不暴露原始信息的前提下实现细粒度权限分配,是解决多租户架构下AI权限动态管控的核心技术路径。
随着大语言模型与企业级SaaS平台深度绑定,传统共享基座架构正面临严峻的合规审查。单一权重共享导致上下文窗口跨租户串扰,且难以满足《数据安全法》对分级分类管理的硬性要求。技术选型决策者在评估公有云或混合云AI服务时,常因权限颗粒度过粗、审计链条断裂而推迟部署计划。逻辑隔离无法阻断底层Embedding向量的隐式泄露,算力资源争抢引发SLA波动,合规响应周期多以周计,严重拖累业务迭代节奏。
- 数据归属边界模糊:客户私有语料混入公共训练池,违反数据主权原则。
- 越权调用难以拦截:缺乏运行时鉴权中间件,默认全员共享Token额度。
- 算力利用率低下:长尾请求阻塞主线程,闲置GPU占比超过40%。
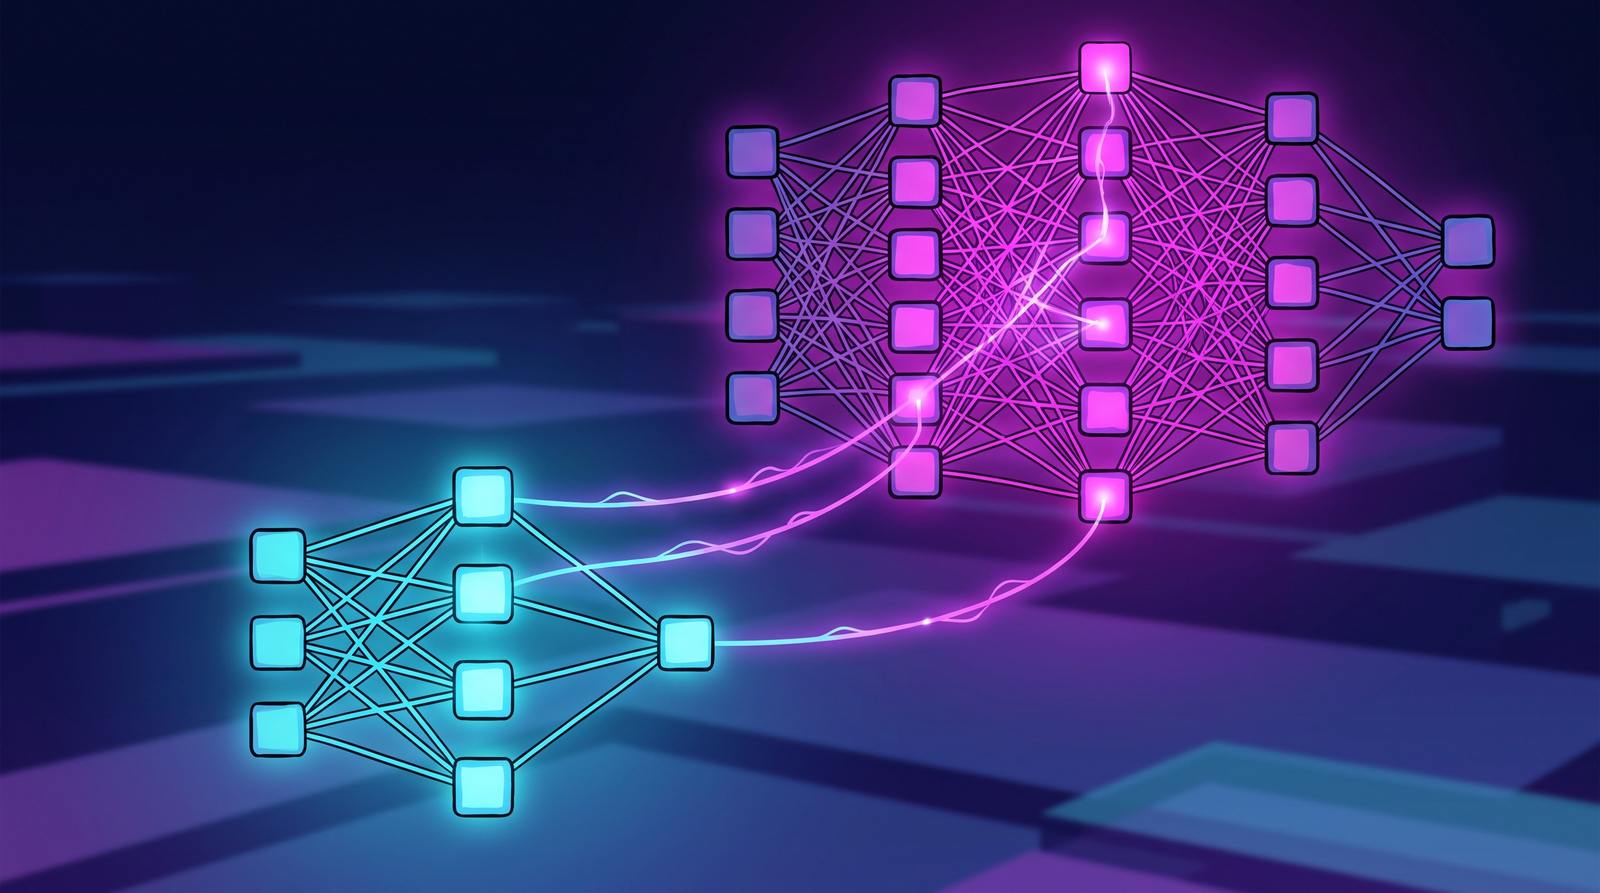
在此背景下,模型蒸馏被正式引入架构重构环节。模型蒸馏是指将大型教师模型的泛化知识迁移至参数规模更小的学生模型中,使其在保持核心推理能力的同时显著降低算力开销的技术范式。结合RBAC机制,企业可为每个租户生成独立的轻量化副本,实现权限下发与模型路由的同步更新。该方案并非简单的剪枝操作,而是依托知识对齐算法构建动态沙箱。当某租户发起查询时,网关层校验身份令牌,随后将请求路由至对应的学生模型实例。各实例仅保留授权领域内的LoRA适配器,未授权模块处于休眠状态,从底层切断越权链路。
模型蒸馏在多租户环境中的动态管控实践方案
将理论转化为工程落地,需建立标准化的数据流转流水线。当前领先的多租户架构下的AI权限动态管控实践通常遵循清洗、对齐、路由、监控四步闭环。技术团队需优先处理数据清洗环节,原始语料经PII擦除后注入结构化提示词模板进行SFT,确保教师模型吸收的是通用逻辑而非企业机密。在知识迁移阶段,需在KD损失函数中引入温度参数T平滑概率分布,防止学生模型过拟合特定租户的噪声数据。路由层则基于JWT声明中的Tenant_ID映射专属模型版本,支持热切换而不中断在线服务。运行时配置权限熔断策略,一旦检测到异常高频调用或越权语义特征,网关立即降级至本地缓存并触发工单。
- 分层冻结策略:固定基础Transformer块,仅微调顶层注意力头,降低灾难性遗忘风险。
- 梯度检查点优化:利用DeepSpeed技术切片激活值,使消费级显卡也能完成百兆级蒸馏任务。
- 数据血缘追踪:记录每次权重更新的来源租户ID,满足第三方审计机构的溯源要求。
- 弹性伸缩队列:vLLM结合Continuous Batching,按租户优先级动态分配KV Cache配额。
模型蒸馏驱动的效率提升与合规效果对比
从技术选型视角审视,替代方案的优劣需通过量化基准验证。以下对比展示了传统共享基座架构与蒸馏隔离架构在实际生产环境中的性能边界。推理延迟方面,共享架构受并发排队影响平均波动至420ms,蒸馏架构稳定在85至110ms,吞吐量提升近4倍。存储开销方面,全量模型占用12GB显存,蒸馏学生模型压缩至0.8GB,支持边缘节点下沉部署。合规通过率方面,传统模式需人工抽检日志且漏报率达7.2%,蒸馏架构实现100%自动化拦截,审计耗时缩短90%。精度损耗方面,经过三轮PPO强化对齐,学生模型在通用基准测试集上保持原模型94.6%的准确率,完全达到商用门槛。
行业落地案例进一步印证了该架构的治理价值。以展会参展商线索抓取AI自动打标标签体系的设计标准为例,过去依赖规则引擎匹配容易误判高净值客户。引入蒸馏后的轻量识别模型后,系统严格遵循最小权限原则,仅放行标注所需的元数据字段。各经销商子账号只能看到自己负责的展区线索,跨区数据流被物理切断。这不仅提升了销售转化效率,更满足了GDPR与个人信息保护法中对数据流向的可追溯要求。
模型蒸馏落地的开源生态与治理趋势
开源社区正在重塑AI治理的基础设施。HuggingFace与LangChain等项目已集成标准化的知识蒸馏管线,降低了企业自建合规屏障的门槛。政策监管层面,多地网信办出台的生成式AI服务备案指引明确要求具备模型版权溯源与权限分级能力。蒸馏技术天然契合这一导向,其轻量化特性便于部署私有化评测探针,实时输出合规评分报告。面对日益收紧的伦理审查,技术决策者应采纳可解释性强的白盒蒸馏路径,避免黑盒迁移带来的不可控偏见。联合联邦学习构建分布式节点,交换梯度而非原始样本,既能维持多租户间的协同进化,又彻底杜绝数据出境风险。规划三年技术路线时,建议将蒸馏作为弹性算力池的核心组件,预留API扩展槽位以适应不断迭代的行业规范。
常见问题
蒸馏是否会导致特定租户的数据污染?
不会。隔离架构采用独立Student实例与LoRA适配器,梯度仅在所属租户沙箱内累积,无全局权重共享。
动态切换是否会引发上下文丢失?
网关层维护会话状态机,切换时携带历史Token摘要快照,确保多轮对话连续性不受路由影响。
如何评估学生模型的合规红线?
部署自动化对抗测试套件,注入越权Prompt与敏感词库,设定阈值自动熔断并上报监管看板。
结语
多租户时代的AI治理已从被动防御转向主动编排。模型蒸馏不仅是算力优化的工程手段,更是落实权限动态管控的底层基础设施。技术领导者应把握开源生态红利,以标准化管线替代黑盒交付,在合规框架内释放智能代理的生产力。

李工
暂无介绍....

评论(0):