
MCP协议演进视角下私有化部署大模型的智能体适配指南
一、梳理私有化部署大模型的基础架构与数据闭环
实现私有化部署大模型的智能体适配,核心在于通过MCP协议标准化工具调用接口,解耦模型推理与业务逻辑,并建立安全可控的本地资源调度机制。决策者需优先评估现有GPU集群显存分配与KV Cache命中率,明确模型规格是否满足多智能体并发需求。
- 确认推理框架选型:主流开源方案包括vLLM与TensorRT-LLM,前者侧重高吞吐动态批处理,后者强调端到端延迟优化。
- 划定数据边界:将核心业务日志、企业知识库进行向量索引,确保私有化部署大模型仅访问授权范围内的向量化切片。确认量化精度策略:混合精度计算可保留关键注意力层的FP16权重,同时降低KV Cache显存占用约40%,显著提升并发吞吐量。
此阶段需输出明确的硬件拓扑图。建议在非生产环境搭建基准测试沙箱,使用标准评测集测量首字延迟与吞吐量。若私有化部署大模型参数量超过70B,必须启用张量并行策略,并在网络层面预留RDMA高速互联通道,避免多卡通信成为系统瓶颈。
二、配置MCP网关实现私有化部署大模型的插件接入
模型上下文协议(MCP)是指一套标准化的开放接口规范,旨在解决大语言模型与外部工具、数据源之间的通信壁垒。在本地环境中部署MCP Server是打通智能体执行链路的关键一步。
- 初始化本地MCP Server:基于官方SDK创建实例,绑定本地端口并配置JWT鉴权中间件。
- 定义资源与工具Schema:严格遵循JSON Schema规范编写函数签名,明确输入参数类型与返回值结构,防止私有化部署大模型生成非法指令。
- 启用Stdio与HTTP传输切换:内部微服务交互推荐HTTP长连接,容器化场景则采用标准输入输出管道降低开销。
网关配置完成后,需进行契约测试。通过自动化工具校验Tool Call返回状态码,确保私有化部署大模型接收到的错误提示具备可解释性。此环节直接决定后续智能体能否准确触发下游业务动作。
三、编排多智能体工作流以激活私有化部署大模型的自主能力
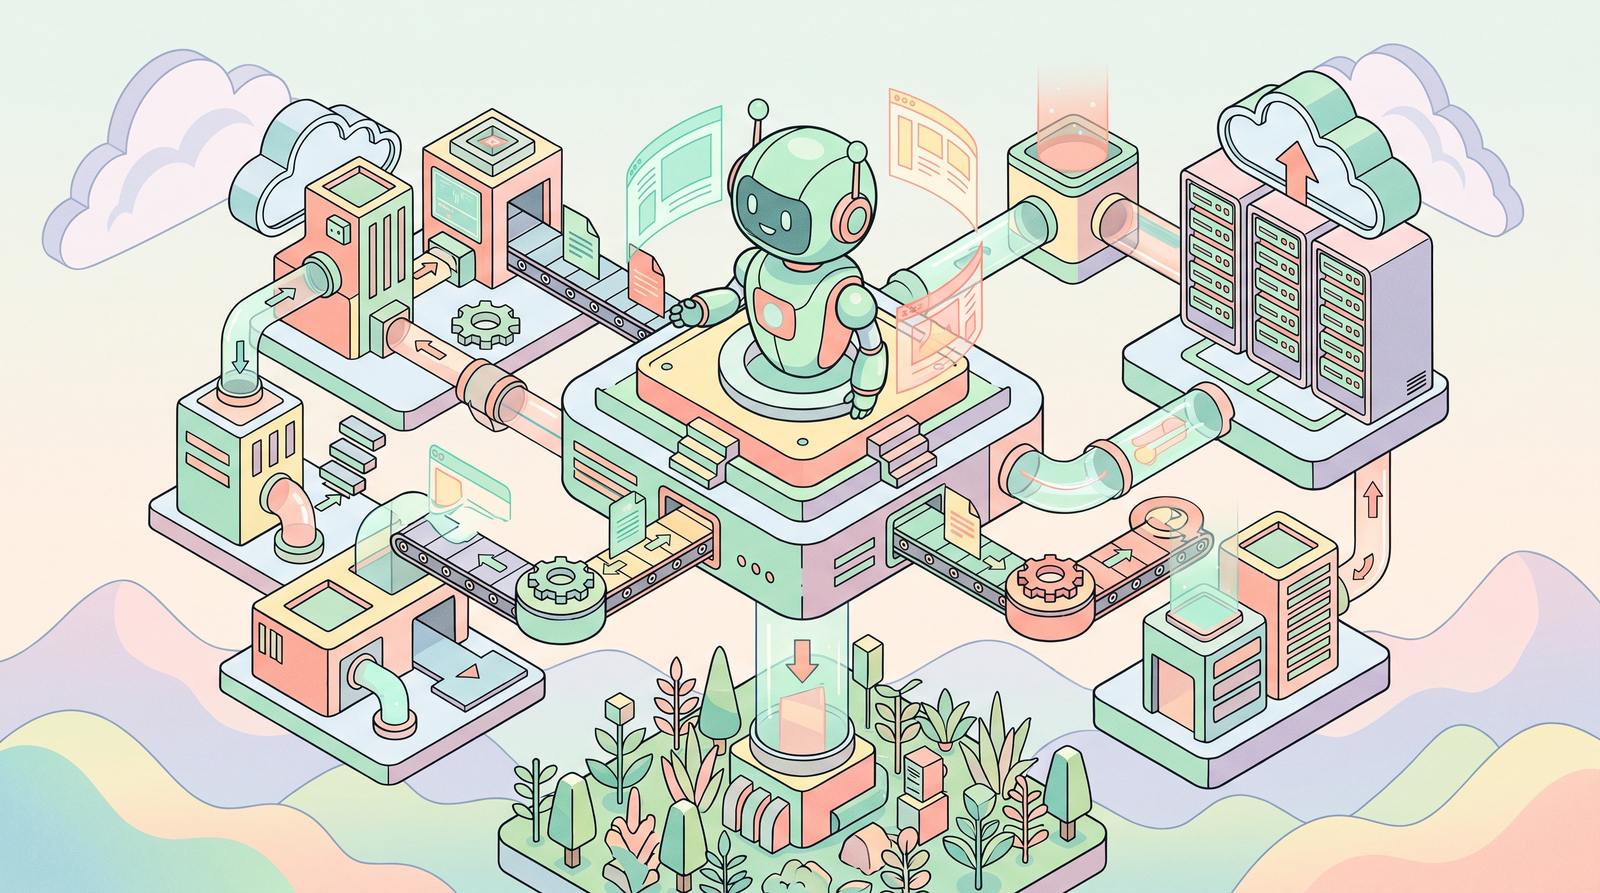
单一模型难以覆盖复杂业务全链,需引入多智能体架构。本步骤聚焦于角色分配、记忆持久化与冲突消解机制的设计。
- 划分职能节点:设置规划器、执行器与审查员,各节点独立挂载轻量级私有化部署大模型实例以降低单点故障风险。
- 构建共享黑板模式:利用Redis维护全局状态字典,实现跨节点的任务进度同步与上下文继承。建议引入LangGraph作为底层编排引擎,其内置的状态保存节点可直接映射至持久层,大幅降低自研代码的维护负担。
- 植入回溯重试逻辑:当子任务失败时,自动收集Trace ID与异常堆栈,触发私有化部署大模型重新生成Prompt策略。
决策者应关注Token消耗分布曲线。通过限制最大生成长度与温度参数,控制幻觉率。在多智能体对话轮次超过阈值时,强制插入摘要压缩模块,维持上下文窗口不溢出。
四、建立私有化部署大模型的安全审计与监控体系
生产级落地离不开可观测性与合规管控。本阶段要求将基础设施指标与应用层日志打通,形成完整的数据溯源链条。
- 部署Prometheus+Grafana监控栈:实时抓取GPU利用率、内存交换率及请求排队长度,设置动态扩缩容阈值。
- 集成红队测试套件:定期注入越狱提示词与敏感实体,验证私有化部署大模型的内容过滤层是否生效。针对提示词注入攻击,需在网关层部署正则过滤器与语义相似度校验模块,拦截偏离原始意图的Query重构请求。
- 启用操作留痕机制:所有Model Context Protocol调用记录需写入只读存储介质,满足等保三级审计要求。
完成上述四层迭代后,即可进入灰度发布流程。建议先对低敏非核心业务开放智能体入口,观察实际交互转化率后再逐步扩大流量池。
常见问题
私有化部署大模型运行内存不足如何缓解?
可启用PagedAttention分块调度算法,结合INT8量化技术压缩权重体积。同时限制并发连接数,采用滚动缓存淘汰旧会话,确保核心业务优先级不被抢占。
MCP协议在断网环境下是否可用?
完全可用。MCP原生支持本地文件读取与进程间通信,无需依赖云端DNS解析。只需在服务器端关闭外网出口路由,即可实现纯内网数据隔离与工具调用。
多智能体出现循环死锁怎么排查?
检查状态机流转边界条件,为每个Agent设置最大重试次数与超时熔断器。引入投票共识机制替代单人决策,并在代码层添加递归深度计数器,超限直接抛出异常终止。
结语
技术选型的本质是在算力成本与智能上限之间寻找平衡点。掌握MCP协议适配路径,将使企业在数据安全的前提下稳步迈入AGI应用深水区。

王工
暂无介绍....


评论(0):