
混合云架构下,初创企业运行大模型的带宽存储预算策略
初创企业采用混合云架构运行大模型的带宽与存储预算规划
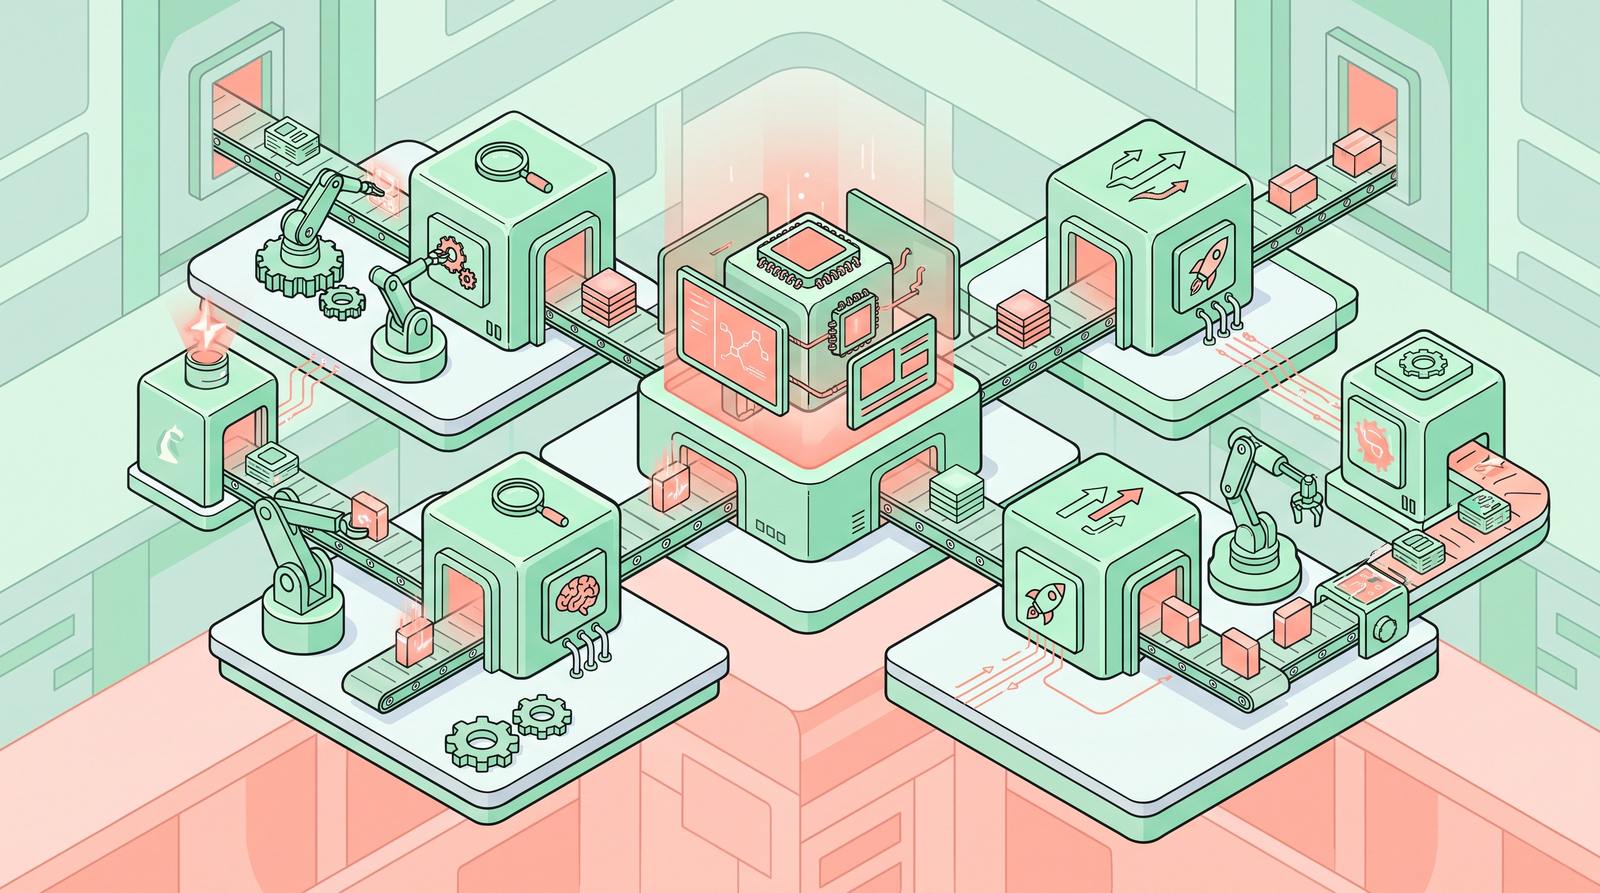
核心在于按数据冷热分层与推理并发峰谷动态调度。将训练数据存于低成本对象存储,高频访问缓存至公有云GPU实例,非实时流量路由至边缘节点,结合预留实例与按需计费组合,可压缩40%以上综合成本。
大模型商业化正从算力堆砌转向精细化运营。初创团队在资金受限条件下,必须建立可量化的资源消耗模型。当前AI产业已进入存量博弈期,技术选型的决策者需关注以下关键维度:
- 存储分层:热数据(KV Cache与活跃权重)置于NVMe SSD,冷数据(原始语料与历史会话)下沉至廉价S3兼容存储,降低IOPS开销。
- 带宽计价:避开公网跨区传输峰值,利用VPC内网互通与CDN回源策略,按实际请求量阶梯计费,消除闲置带宽损耗。
- 算力池化:通过Kubernetes编排容器化推理服务,实现CPU与GPU异构资源混部,利用虚拟化技术打破物理机边界。
- 计费优化:采用竞价实例处理长尾批处理任务,保留实例覆盖基础在线服务,形成平滑的成本护城河。
多方案横向对比:公有云弹性、私有云沉淀与混合调度策略
混合云大模型部署是指将核心算力与热数据托管于公有云以应对弹性并发,同时将冷数据、低敏业务及合规负载迁移至自建机房或私有云,通过统一控制面实现算力调度的架构模式。
- 全公有云方案:采购门槛最低,支持秒级扩缩容,但长期固定负载的综合IT支出呈指数级增长,易受云厂商定价策略掣肘。
- 纯私有云方案:数据主权完整,单次建设成本高昂,扩容周期长达数周,不适合快速迭代的AI原生产品与敏捷研发流程。
- 混合云架构:通过API网关统一路由,计算层采用Spot实例抢占空闲算力,存储层启用跨云副本机制,兼顾成本与高可用。
- 网络拓扑对比:集中式架构延迟随并发线性上升,分布式Mesh网络可降低骨干网拥塞概率,提升端到端响应稳定性。
典型负载测试:AI 教育应用同步流与 AI 翻译对比异步批处理
不同业务模态对网络吞吐与磁盘I/O的依赖存在显著差异,直接决定预算分配比例。在实际工程验证中,两类典型场景表现出截然不同的资源消耗曲线:
- 交互式AI 教育应用要求毫秒级首字延迟,需预留充足的上行带宽与显存带宽,存储侧侧重高并发随机读取与小文件聚合操作。
- 离线AI 翻译对比任务属于计算密集型,可接受分钟级排队延迟,适合批量加载至边缘节点执行,存储侧依赖高顺序写入吞吐量。
- 通过监控Prometheus指标,将带宽预算的60%倾斜至低延迟链路,其余40%用于高吞吐冷数据预热,可实现商业ROI最大化。
- 市场趋势显示,多模态交互正在取代单一文本生成,视频帧解码带来的瞬时IOPS激增,倒逼底层架构向存算分离方向演进。
初创企业采用混合云架构运行大模型的带宽与存储预算规划的实施路径
决策者应遵循先评估后切片的原则,避免盲目上云或过度囤积硬件。标准化落地流程如下:
- 阶段一:梳理过去三个月的Token消耗量、并发QPS及存储增长率,绘制基线负载画像,明确系统SLA红线与容灾等级。
- 阶段二:配置自动化策略,设定阈值触发公有云实例自动伸缩,同时建立本地NAS作为数据湖缓冲层,大幅减少跨域请求延迟。
- 阶段三:引入FinOps工具链进行账单溯源,每季度复盘单位Token的边际成本,动态调整云厂商合同条款与阶梯折扣协议。
- 阶段四:部署灰度发布管道,新模型版本先在私有云沙箱验证性能与功耗,达标后再向公有云主力集群全量推送上线。
常见问题
如何确定混合云各层的存储容量配比?
依据访问频次判定。近三十天调用超千次的权重定为热数据,占比约百分之十五至二十,余量全部转存低频介质,可按季度轮转。
带宽突发时如何避免预算超支?
启用VPC终端节点阻断公网直连,配置应用层令牌桶限流。QPS越限时自动降级非核心模块,并无缝切换至备用推理实例。
混合架构能否支持多模型并行推理?
可行。借助Cgroup与Namespace隔离推理进程,利用共享内存传递张量数据,单物理节点可同时稳定承载多款中型模型。

李工
暂无介绍....

评论(0):