
推理加速方案如何重塑AI落地成本与商业化路径
第一步:明确推理加速方案的架构适配与选型逻辑
通过部署推理加速方案,可将端到端延迟压低百分之三十至七十,直接削减云端算力开销,使中小团队以低边际成本跑通付费转化与规模化商用。
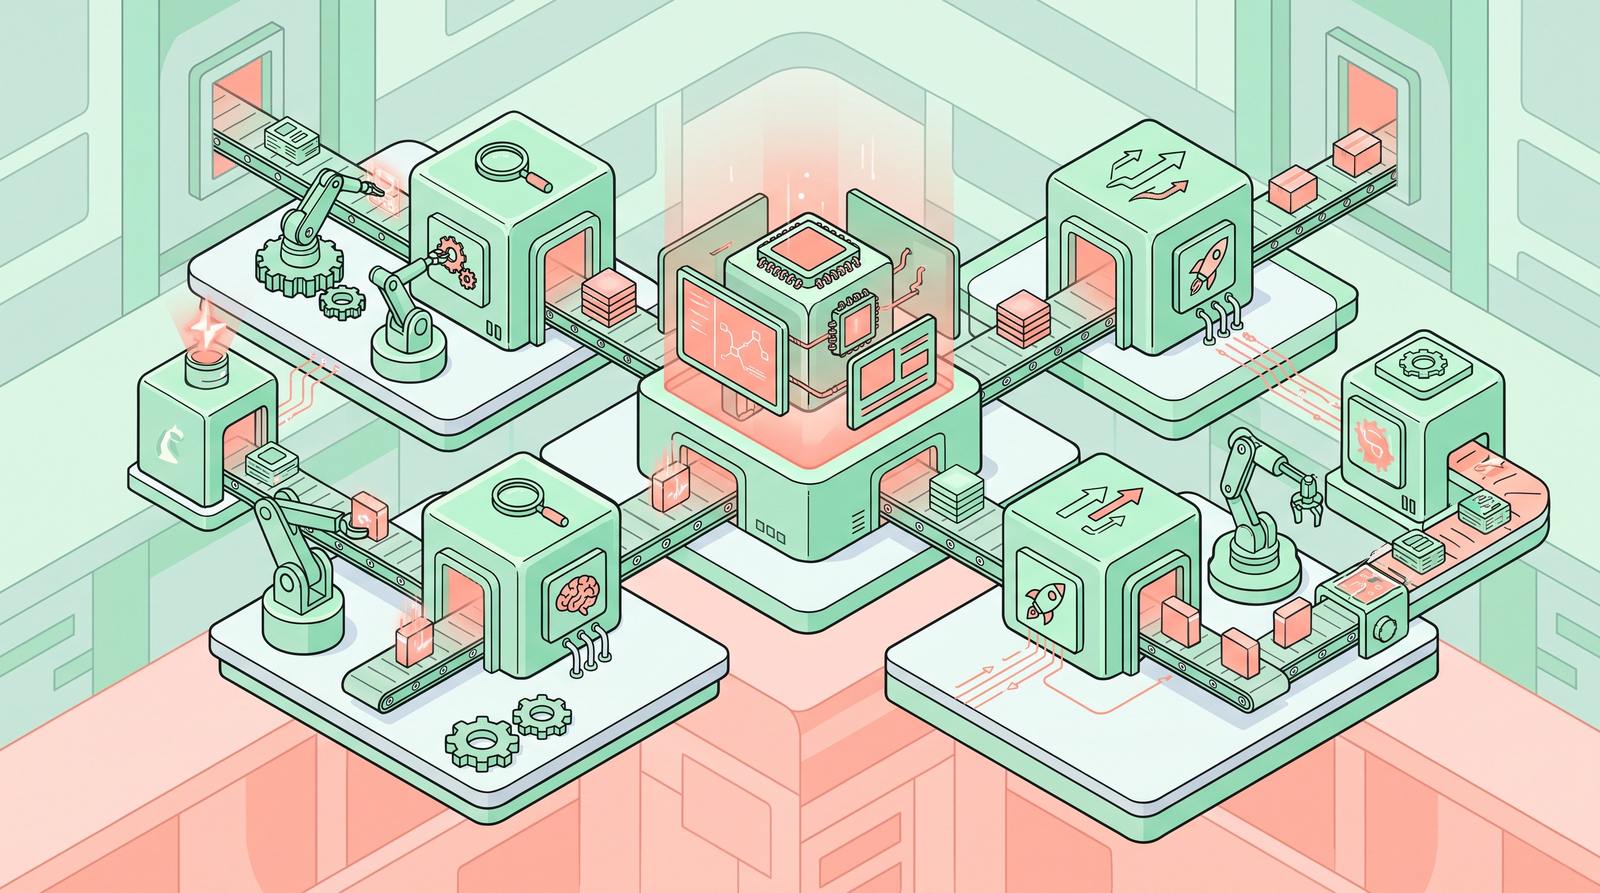
推理加速方案是指通过算子融合、动态图编译与量化降维等技术手段,在不损失核心精度的前提下提升模型预测吞吐量的一套工程体系。一线团队在立项初期,需按以下路径完成技术栈对齐:
- 评估算力基线:对比目标芯片的TOPS与内存带宽,确定是否采用异构计算或纯CPU路线。
- 匹配模型形态:区分对话型、多模态与Agent编排类任务,优先锁定支持算子注册的框架。
- 设定延迟阈值:明确首Token生成时间(TTFT)与每秒输出Token数(TPS)的业务红线。
云实例按时计费与边缘设备一次性买断的账本需分开核算,避免将固定折旧误判为可变成本。此阶段切忌盲目堆砌参数,建议利用基准测试集进行灰度压测,用实测吞吐数据反推采购清单,确保每一分投入都指向明确的性能拐点。
第二步:实施推理加速方案的核心编译与量化流程
完成选型后,工程重心转入代码级优化。该环节直接决定最终的成本结构,实操中应严格遵循标准化流水线:
- 静态图转换:将PyTorch或TensorFlow原生权重导出为ONNX格式,消除冗余控制流节点。
- 精度量化:采用INT8或FP8替代FP16,结合校准数据集重建分布,通常可压缩四成显存占用。
- 图层融合:调用底层编译器自动合并Norm、激活函数与矩阵乘法,减少内存读写频次。
面对需要深度思考的任务,如处理AI 复杂数学题逐步推导场景,长序列生成极易触发显存溢出。此时需引入KV Cache优化与投机解码策略,以牺牲极小精度换取线性加速比。团队在调试时应紧盯GPU利用率曲线,若低于百分之八十则说明算子调度存在瓶颈,需排查内核发射延迟。
第三步:在垂直场景中验证推理加速方案的商业价值
技术指标转化为财务指标,是商业化破局的关键。企业需将优化后的引擎嵌入实际业务流,观察用户行为与留存变化:
- 边缘侧下沉:针对高并发交互需求,将轻量化模型部署至终端设备。典型如智能音箱开发项目中,本地推理拦截了百分之六十的无效唤醒,大幅降低云端API账单。
- 分层计费设计:依据延迟敏感度划分服务等级。普通查询走低成本队列,实时翻译与客服代理分配独立高优通道,实现收益最大化。
- ROI测算模型:建立单次请求成本监控看板,当单Token成本跌破行业均值两成时,即可启动大规模营销投放。
市场反馈往往滞后于技术上线。建议在核心节点设置A/B测试对照组,对比加速前后的转化率差异,用真实订单数据校准定价策略,确保技术投入直接映射为营收增长。
第四步:构建基于推理加速方案的持续迭代体系
AI赛道竞争格局已从拼首发转向拼持久力。稳定的线上表现依赖自动化运维机制:
- 动态路由调度:根据时段流量波动,自动切换模型版本与并行线程数,防止资源浪费。
- 冷启动缓存预热:对高频Prompt模板预加载上下文,消除重复解析开销。
- 故障回滚预案:配置阈值告警,一旦延迟抖动超标准,立即切流至备用轻量模型。
这套组合拳能将年度运维人力缩减三分之一。技术团队应将精力从救火式调优抽离,转向新场景探索。当单位算力产出稳定攀升,产品的毛利率自然突破盈亏平衡点,形成正向现金流循环。
常见问题
量化导致的效果下降如何补救?
优先使用混合精度量化,保留关键层为FP16;其次扩大校准数据集覆盖面;最后引入知识蒸馏,用大模型标签微调小模型恢复准确率。
边缘设备算力不足能否运行大模型?
可以。通过模型剪枝剔除稀疏参数,配合IPU等专用加速卡进行指令集重排。重点是将非实时推理转至云端协同,终端仅负责特征提取与意图识别。
加速方案升级会破坏原有接口吗?
规范化的推理服务需封装统一API网关。底层算子替换对外透明,只需保证输入输出张量维度一致,即可实现热更新而无感切换。
落地执行清单
建议研发负责人对照上述步骤建立里程碑检查表。每周同步一次延迟压测报告,每月复核一次云服务器账单与毛利率曲线,确保技术演进始终服务于商业目标。

李工
暂无介绍....

评论(0):