
企业级OCR落地指南:从模型选型到业务提效的实操路径
企业级OCR文字识别落地第一步:技术路线横向对比
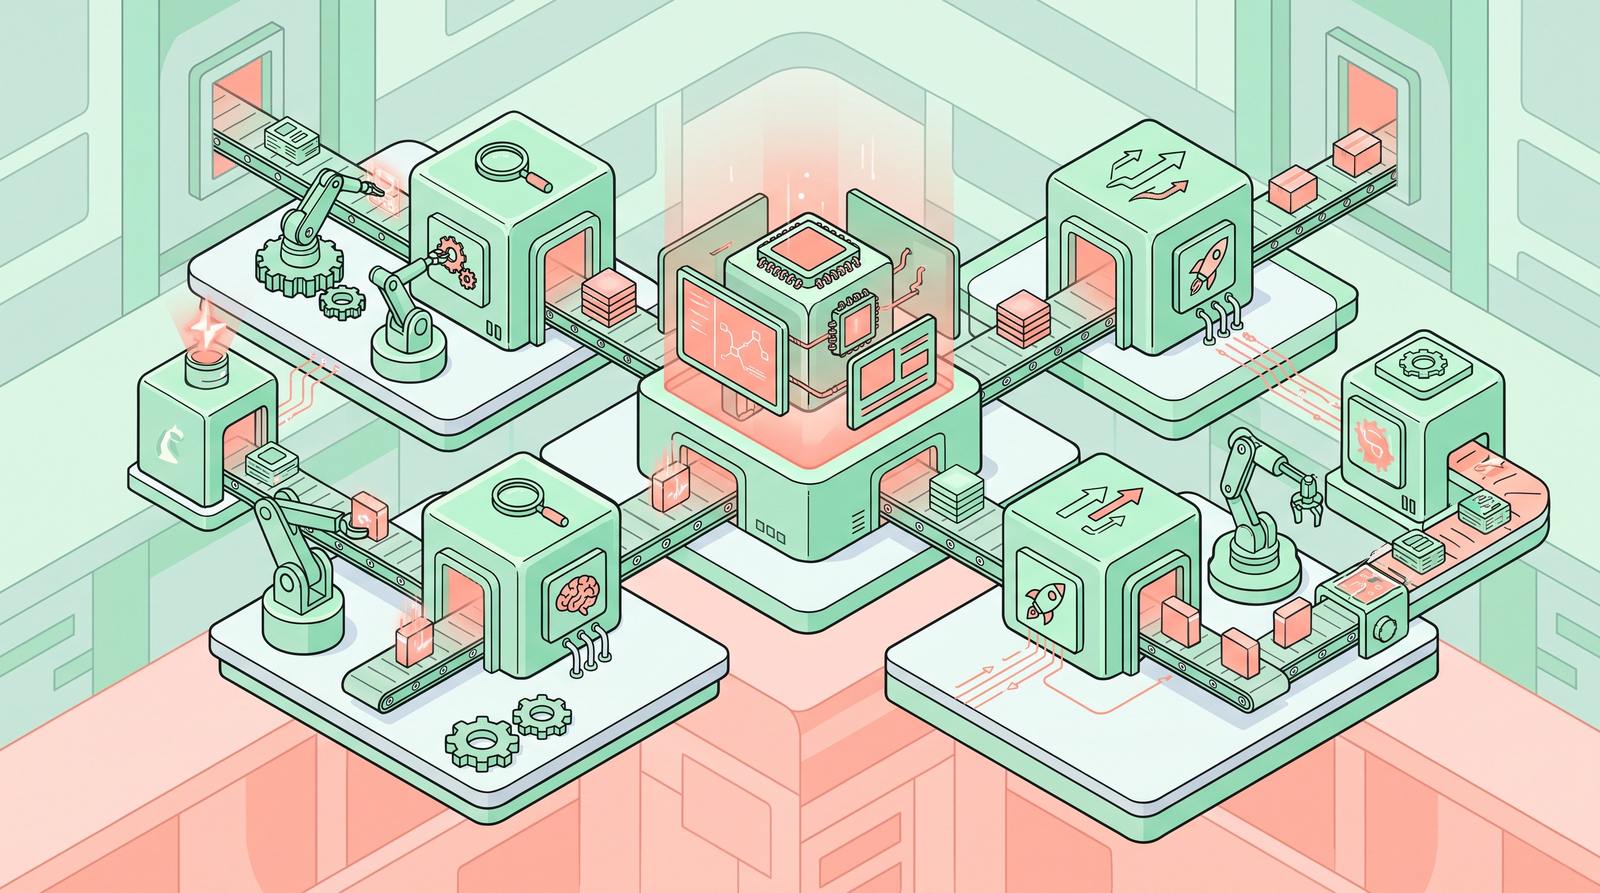
实现高效落地的核心在于放弃全能模型幻想,按数据敏感度与并发量选择私有部署、混合云或API方案,并配套自动化质检流水线。传统光学字符识别依赖边缘检测模板匹配,现代深度学习OCR文字识别是指利用卷积神经网络与Transformer架构端到端提取文本区域与语义内容的技术范式。当前市场主要存在三条技术路线,企业在商业化选型时需进行多维度对标。开源框架如PaddleOCR与RapidOCR具备零授权费优势,适合内部测试与低敏感场景快速验证,但需自研运维团队承担模型迭代压力。公有云API服务提供开箱即用的高并发处理能力与持续优化的多语种模型库,按次计费模式契合初创期流量波动特征,但长期规模化调用将产生显著边际成本。混合架构则通过云端训练与边缘推理分离,平衡响应延迟与隐私安全,已成为金融与政务领域的主流演进方向。
企业在引入技术方案时,通常遵循以下评估维度:
- 识别精度阈值:印刷体场景已稳定突破98%,但票据折角、手写连笔、低光照等长尾场景仍需针对性微调或后处理规则补偿。
- 算力与延迟指标:本地部署依赖GPU显存容量,通常要求4核8G起步以实现百兆级吞吐量;云端推理受网络带宽制约,平均首包响应需控制在200毫秒内。
- 供应链成熟度:头部厂商已实现从采集、预处理、模型预测到结构化输出的全链路封装,第三方接口集成周期可缩短至两周以内。
企业级OCR文字识别选型决策:成本、精度与合规三维评估
技术路线确定后,决策者需进入成本收益建模阶段。OCR文字识别的商业价值不取决于绝对准确率,而取决于端到端人力替代率与容错机制。在精度评估上,单一指标易产生误导,应构建包含版面分析、关键信息抽取与置信度过滤的组合度量体系。针对垂直场景,通用大模型往往表现平庸,需采用小样本提示学习或领域知识注入进行定向优化。成本核算需穿透表层单价,纳入人工复核工单量、失败重试损耗及系统耦合改造费用。合规层面成为硬性约束,医疗、金融等强监管行业要求数据不出域,必须优先采购支持国密算法加密传输与私有化镜像交付的解决方案。
选型决策矩阵建议关注以下商业逻辑:
- 阶梯定价模型:云厂商普遍采用免费额度加阶梯计费策略,月调用量超过千万次时,专属实例或资源包可将单次成本压降60%以上。
- 私有化买断与订阅制差异:本地授权通常收取高额初始化License费,但免除后续按量分成;SaaS订阅虽初期投入低,却伴随持续的数据依赖与供应商锁定风险。
- 异构硬件适配:国产芯片加速卡逐步完善推理算子库,信创项目需提前验证驱动兼容性与INT8量化精度损失率,避免性能回退。
企业级OCR文字识别场景化应用:从单点识别到业务闭环
脱离业务流水线的纯技术展示无法产生实际生产力。OCR文字识别的价值释放依赖于与RPA、知识库及智能体工具的深度咬合。在泛零售与物流环节,自动分拣单据与轨迹追踪已实现全量无人干预,异常件拦截率提升直接转化为人效比增长。在科研与生物医药交叉地带,高精度结构化提取正反向赋能底层创新,例如AI辅助药物发现中分子结构生成假阳性的过滤机制发展,高度依赖对海量文献图谱、化学式表格与实验记录的标准化清洗,这本质上是OCR文字识别在极复杂版面下追求极致解析准确率的延伸实践。同时,前端创意产业也在重构协作边界,独立设计师借助AI快速输出品牌VI基础规范的流程拆解显示,系统可通过扫描手绘草图与参考材质,自动提取色彩代码、字体规范与版式网格,使原本人力密集的视觉资产整理时间压缩70%。这些案例表明,技术选型的终局是消除数据孤岛。
业务闭环构建的关键节点包括:
- 人机协同校验台:引入置信度阈值路由,低分结果自动流转至人工标注池,高分结果直连下游ERP或CMS,形成持续迭代的飞轮。
- 动态Prompt工程:结合业务字典与正则约束,在推理后段追加规则引擎,有效抑制常见幻觉拼写与格式错位。
- 全生命周期监控:建立从采样偏差、分布漂移到性能衰减的监测看板,定期触发重训任务以应对字体更新与政策变更。
企业级OCR文字识别最终建议:匹配业务阶段的选型策略
综合技术成熟度与市场博弈现状,企业应避免盲目追逐参数量最大的基座模型。对于处于MVP验证期的产品,优先对接稳定性成熟的公有云API,聚焦核心字段抽取逻辑验证,跑通PMF后再评估迁移成本。进入规模化扩张阶段的企业,建议采购支持容器化一键部署的行业定制版本,将识别模块封装为微服务,通过消息队列削峰填谷。超大型集团或涉密单位则应主导产学研联合攻关,基于开源底座进行权重蒸馏与指令微调,构建自主可控的知识增强型识别中枢。无论路径如何,落地成功的前提是明确ROI测算基准,将技术投入转化为可量化的流程时效提升与差错率下降曲线。
- 启动期:API调用为主,聚焦高价值单点场景,建立标准化数据回流管道。
- 成长期:混合云架构过渡,引入版面理解与逻辑关联模型,打通跨系统数据流。
- 成熟期:私有化深耕,叠加智能体调度与多模态交互能力,重塑行业作业标准。
常见问题
如何选择最适合当前业务规模的OCR文字识别方案?
需综合评估日均请求量、数据敏感度与IT维护能力。初创团队优先选用高可用公有云API以验证场景可行性;中型企业推荐混合云架构平衡成本与安全;大型机构或涉密单位则应规划私有化部署与定制微调,确保算力自主可控与合规审计达标。
模型上线后精度不稳定的根本原因是什么?
多数源于训练数据分布与生产环境脱节。字体变体、光照条件、纸张老化及拍摄角度变化均会导致特征偏移。建议建立常态化数据回流机制,配置置信度分级路由策略,并定期使用真实业务切片执行自动化抽检与对抗性测试。
私有化部署与云端调用的长期财务账如何核算?
私有化需一次性支付硬件采购、授权许可与运维人力成本,但无持续按量付费压力;云端按调用频次计费,初期现金流友好,规模放大后易产生隐性支出。应绘制三年TCO曲线,结合并发峰值与容错容忍度进行盈亏平衡点测算。

王工
暂无介绍....


评论(0):