
垂直大模型微调:企业级AI写作辅助的落地路径解析
步骤一:需求拆解与语料治理,奠定AI写作辅助基座
垂直大模型微调通过注入企业专属语料,使通用大模型掌握特定行业术语与行文规范,从而精准落地企业级AI写作辅助。
传统通用模型在生成财报、专利或技术文档时,常出现逻辑松散与术语偏差。一线团队需先完成数据盘点,剔除涉密信息后,将历史优质稿件、行业标准、合规红线及人工修正记录转化为结构化数据集。此环节直接决定后续模型的学习上限与边界。
- 文本清洗去重:剔除重复片段与低质量抓取内容,统一UTF-8编码与段落层级。
- 实体标注与格式化:使用NER工具抽取专业名词、产品型号与核心参数,构建知识图谱关联字段。
- 数据集划分:严格按8:2比例切分训练集与验证集,预留10%作为独立测试池,杜绝数据泄漏。
语料治理不仅是技术前置动作,更是资产沉淀过程。通过建立版本控制机制,团队可追溯每一次数据迭代对生成质量的边际影响,避免脏数据污染导致的方向性偏离。
步骤二:大模型微调与指令集开发,强化垂直场景理解力
完成数据准备后,进入核心训练阶段。大模型微调是指针对特定领域数据对基础大语言模型进行二次训练,使其在专业场景下具备更高适配度的技术过程。建议采用LoRA或QLoRA等参数高效微调技术,在冻结主干网络的前提下,仅训练低秩矩阵,大幅降低显存占用与算力成本。
- 指令集构建:围绕角色设定、背景输入、约束条件与输出格式设计Prompt模板,覆盖大纲生成、扩写润色、摘要提取等高频任务。
- 防遗忘机制:在损失函数中加入交叉熵惩罚项,保留底座模型的通用语言能力与常识推理。
- 偏好对齐:引入DPO算法,利用人工打分排序样本,使模型输出严格符合企业合规要求与行文调性。
训练周期通常控制在数日至一周。期间需每日监控Loss曲线下降斜率与验证集PPL指标。当指标收敛且无过拟合迹象时,保存最佳Checkpoint导出权重文件,结束本阶段工作。
步骤三:工程化部署与量化加速,打通AI写作辅助最后一公里
模型训练完毕并非终点,工程落地才是检验价值的试金石。企业需将权重文件加载至vLLM或TGI等推理引擎,配置动态批处理以应对波峰波谷的请求变化。为兼顾延迟与显存效率,可执行INT4或FP8量化压缩,同时保持输出精度损耗低于3%。
- 服务搭建:依托Kubernetes容器化部署,配置HPA弹性伸缩策略,自动随负载调整Pod数量。
- 接口封装:通过RESTful API对外暴露能力,集成JWT鉴权、Token计费与请求限流中间件。
- 压测验证:模拟百人并发在线协作场景,记录首字生成时间与每秒吞吐量,确保SLA达标。
压力测试稳定后,即可向业务线灰度开放。收集真实交互日志中的Bad Case,归类至语义歧义、事实错误或格式混乱三类,为下一轮增量微调提供靶向数据。
步骤四:智能体编排与工作流集成,放大AI写作辅助商业价值
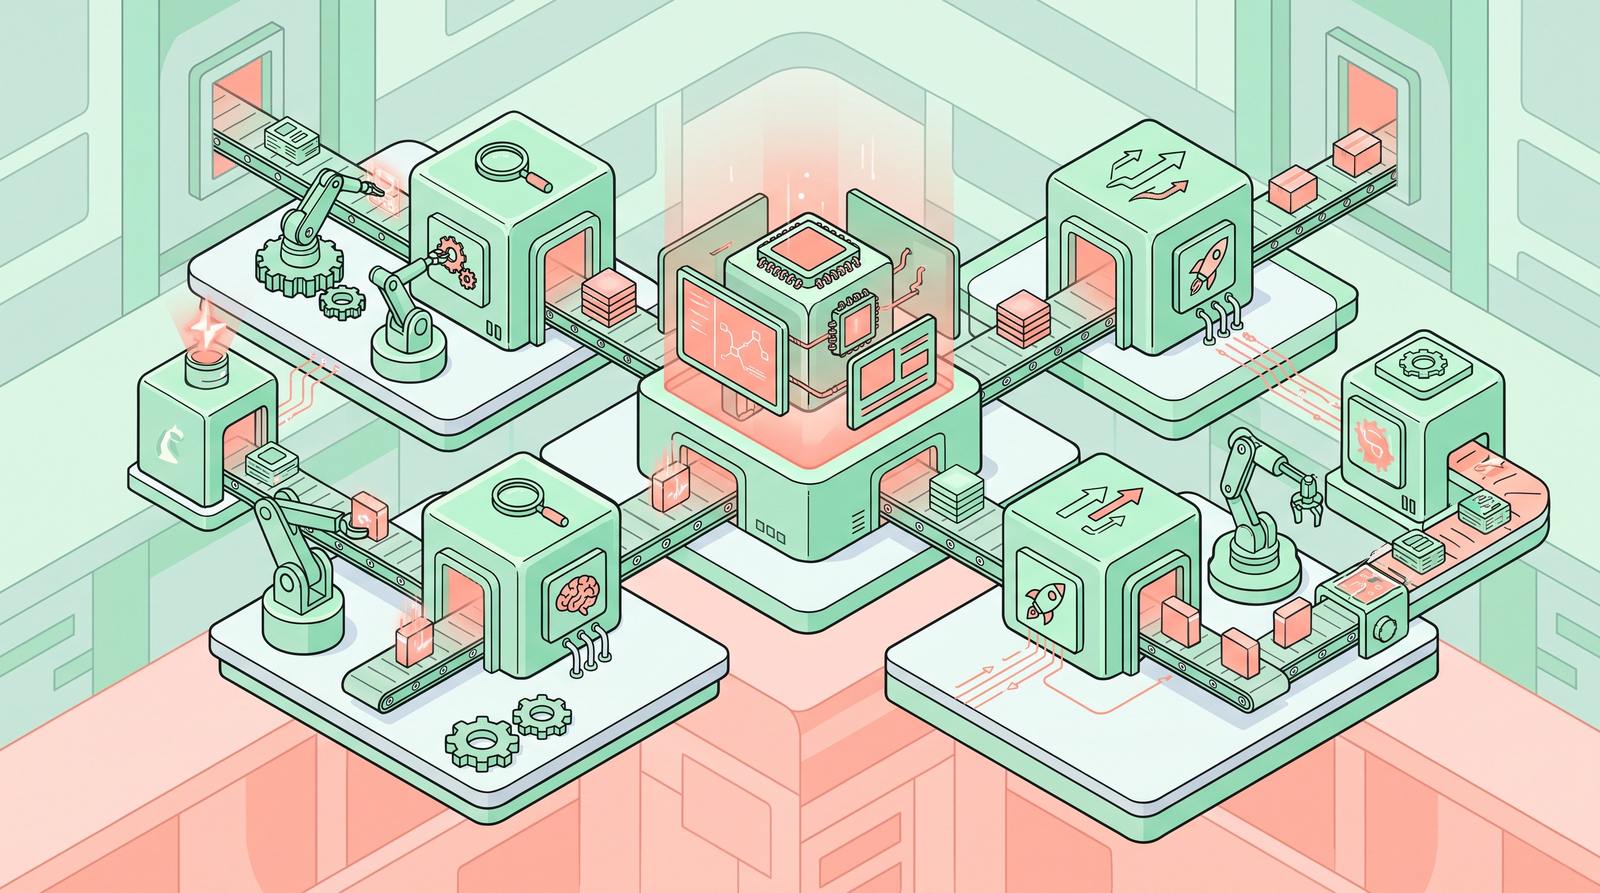
单一模型仅能解决内容生成问题,规模化增效需依赖系统级架构。利用自动化调度平台串联多模态AI工具的业务流搭建实例表明,将微调模型与OCR文档解析、表格自动生成、合规审查模块深度耦合,可形成端到端的智能内容生产管线。
- 链路设计:用户导入原始素材→触发NLP预处理提取关键点→调用微调模型生成结构化初稿→经规则引擎核验数据一致性→最终渲染排版交付。
- 人机协同:在关键节点设置人工审批闸门,支持一键修改、回溯对比与版本快照,降低一线员工使用门槛。
- 商业化闭环:按调用次数或订阅制收费,通过埋点分析功能使用频次,持续优化ROI与客户留存率。
该架构不仅重塑内容生产范式,更构建了差异化竞争壁垒。随着行业落地案例增多,定制化垂直方案正逐步渗透金融、制造等领域,成为B端采购新标准。
常见问题
微调所需数据量不足如何应对?
可采用合成数据增强技术,利用高质量通用模型生成相似样本文本,结合人工抽检确保逻辑严密性,有效填补样本缺口。
如何评估微调后的实际写作效果?
建立多维度评分卡,涵盖术语准确率、结构完整度与客户满意度。通过A/B测试对比通用模型与微调模型的实际产出差异。
私有化部署能否满足实时交互需求?
可以。通过vGPU切片技术与张量并行策略优化,单机多卡集群可实现毫秒级响应,完全支撑高并发在线编辑场景。

李工
暂无介绍....

评论(0):