
模型量化部署:降本增效的架构设计与商业化落地指南
第一步:模型量化部署的场景界定与选型评估
模型量化部署通过压缩网络权重精度并适配专用推理内核,以极低算力损耗实现高并发响应,是企业AI应用降本增效的最优解。
模型量化部署是指将预训练大模型的高精度浮点参数转换为低比特整数格式,并在目标硬件上完成加速运行的系统工程。面向技术选型的决策者,需依据业务SLA划定精度容忍边界,避免过度优化导致可用性断裂。当前技术路线对比如下:
- PTQ(训练后量化)免重训成本低,适用于意图识别与文档摘要等静态任务。
- QAT(感知训练量化)引入校准数据参与前向传播,多用于代码生成与复杂逻辑推理。
- 混合精度方案保留关键层FP16,兼顾延迟与准确率,适合实时多模态交互场景。
决策时应优先核对芯片厂商提供的算子支持矩阵,剔除未覆盖的自定义算子,防止部署期出现兼容阻塞。
第二步:模型量化部署的架构设计与参数配置
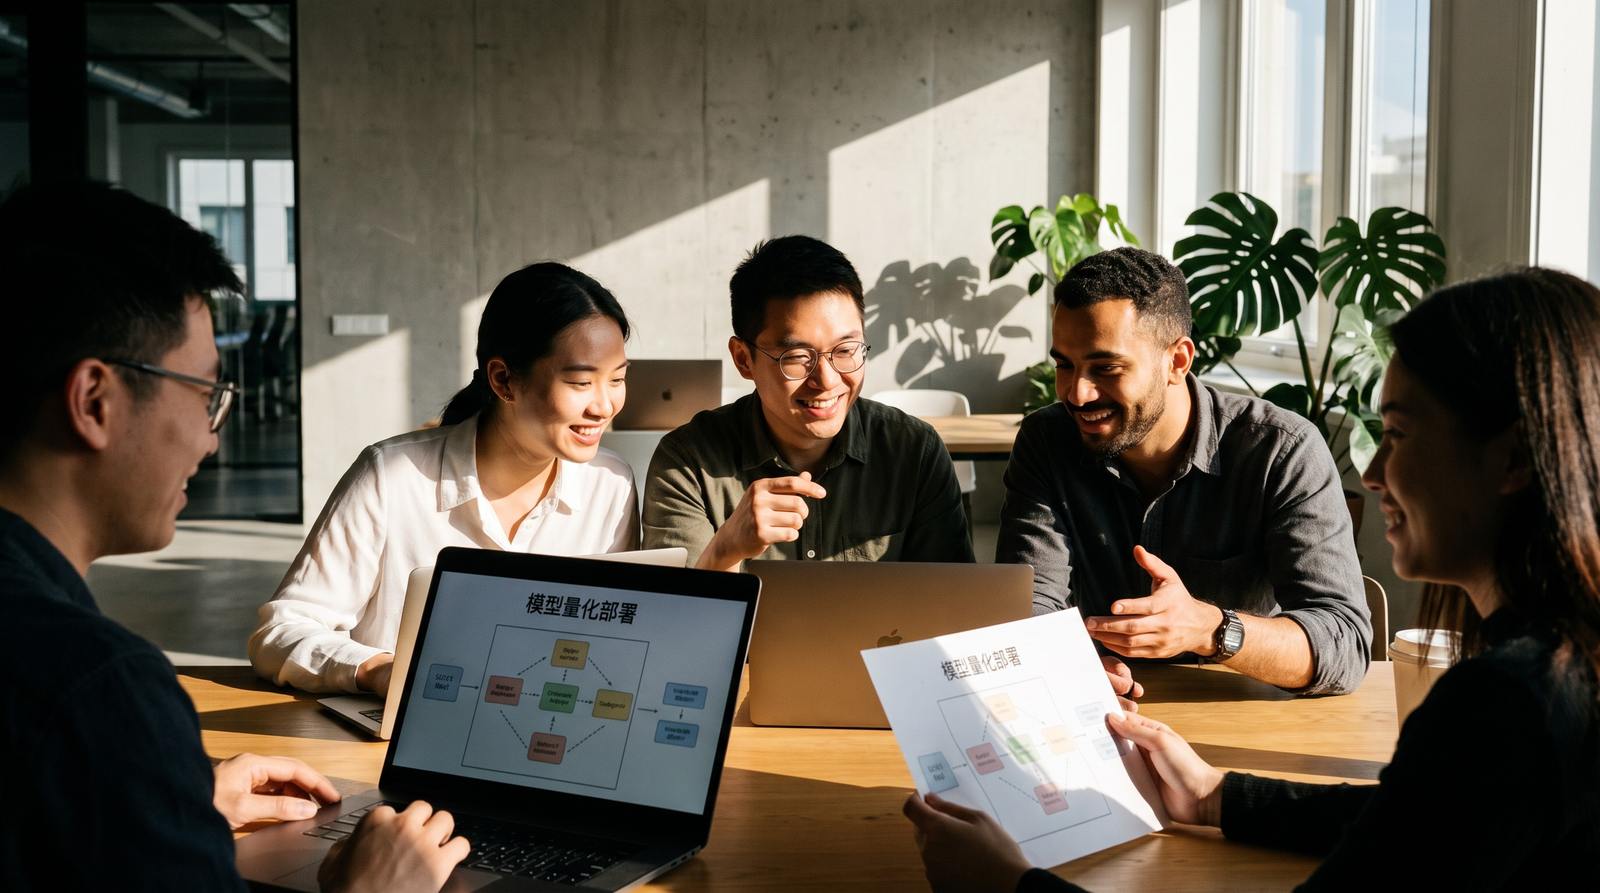
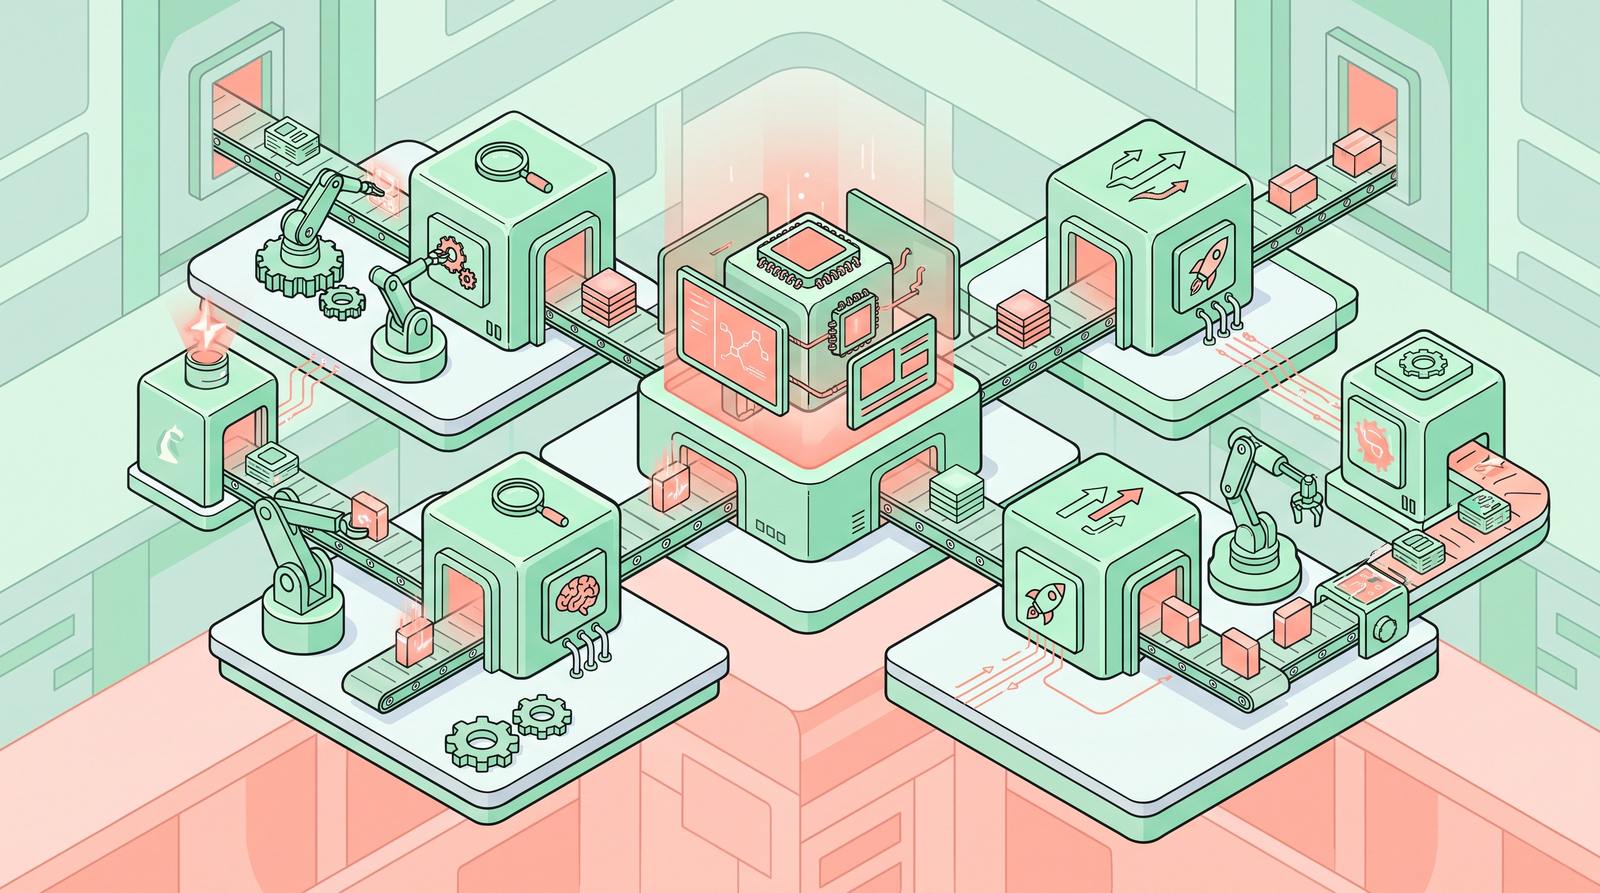
进入工程实施阶段,需按数据流向拆解部署链路,确保各组件无缝衔接。架构设计遵循以下递进步骤:
- 基线采集:导出原始FP16权重的吞吐量与显存占用数据,建立性能对照基准。
- 格式转换:利用TensorRT或llama.cpp引擎执行权重剪枝,设定通道级块状量化策略,抑制异常值干扰。
- 内核替换:加载针对目标架构优化的推理运行时库,启用张量并行与连续批处理机制。
配置环节需严格限制动态序列长度上限,设置早退阈值,防止OOM导致服务雪崩。压测阶段应模拟峰值流量,验证队列堆积时的丢弃策略是否触发预期告警。
第三步:模型量化部署的行业落地与商业验证
技术方案必须转化为可计量的商业指标,方能通过立项审批。智能体编排与RAG检索系统是当前消耗算力最大的载体,单轮API调用成本经压缩后可下降六成。典型落地路径包括:
- 金融风控:采用本地化私有部署方案,满足监管数据不出域要求,同时支撑毫秒级反欺诈拦截。
- 智能制造:将视觉检测模型下沉至工控机边缘节点,切断云端依赖,保障产线不间断运行。
- 内容出海:结合轻量级翻译代理,通过CDN边缘缓存分发结果,大幅削减海外节点带宽支出。
市场竞争焦点已从单一模型参数量转向全流程流水线效率。头部云服务商已推出自动化部署控制台,中小企业可采用Serverless按需计费模式,彻底消除闲置资源沉没成本。
第四步:模型量化部署的效能追踪与成本控制
上线后的持续运营决定项目生命周期。决策者需建立量化审计仪表盘,将技术指标映射至财务报表。核心核算维度如下:
- 算力摊销:对比同等并发规模,量化集群较全精度集群节省的云资源账单比例,行业均值达50%至70%。
- 存储周转:向量索引体积缩减后,磁盘IOPS压力显著缓解,运维工时投入预计减少三分之一。
- 商业转化:推理门槛降低后,内部提效插件与对外SaaS接口的定价弹性同步拓宽,直接拉动客单价增长。
建议每季度开展容量规划评审,根据P99延迟波动曲线动态调整扩缩容策略,确保边际成本始终低于收入增量。
常见问题
量化后模型效果不达标怎么办?
优先检查校准数据集的业务代表性,替换为近三个月真实日志;若仍无效,启用QAT流程补充训练2至3个周期,重点修正极端值截断带来的梯度误差。
边缘设备算力不足如何调度?
采用分层卸载架构,高频简单请求由终端INT4模型直出,复杂逻辑异步转发至云端高精度节点;配合容器化沙箱隔离依赖包,保障低功耗稳定运行。
如何规避底层供应商锁定风险?
统一使用ONNX标准格式导出计算图,禁止硬编码特定厂商私有算子;定期切换开源推理框架交叉验证,维持技术栈的中立性与可移植性。
总结与执行清单
模型量化部署绝非单纯的技术降级,而是资源重构的商业杠杆。技术决策者应从单点试点切入,跑通数据流转链路后再行规模化复制。组建算法、运维与财务联合小组,将延迟指标与预算偏差纳入同一考核体系,即可将技术红利转化为可持续的产品竞争力。

陈工
暂无介绍....

评论(0):