
移动端 AI 阅读器排行揭示底层竞争与商业化路径
移动端 AI 阅读器排行:底层技术架构解析
排行显示,竞争核心在于语义解析精度与端云协同效率。头部应用依托云端算力处理复杂文档,结合本地引擎保隐私,已确立“基础免费+订阅增值”的商业化路径。
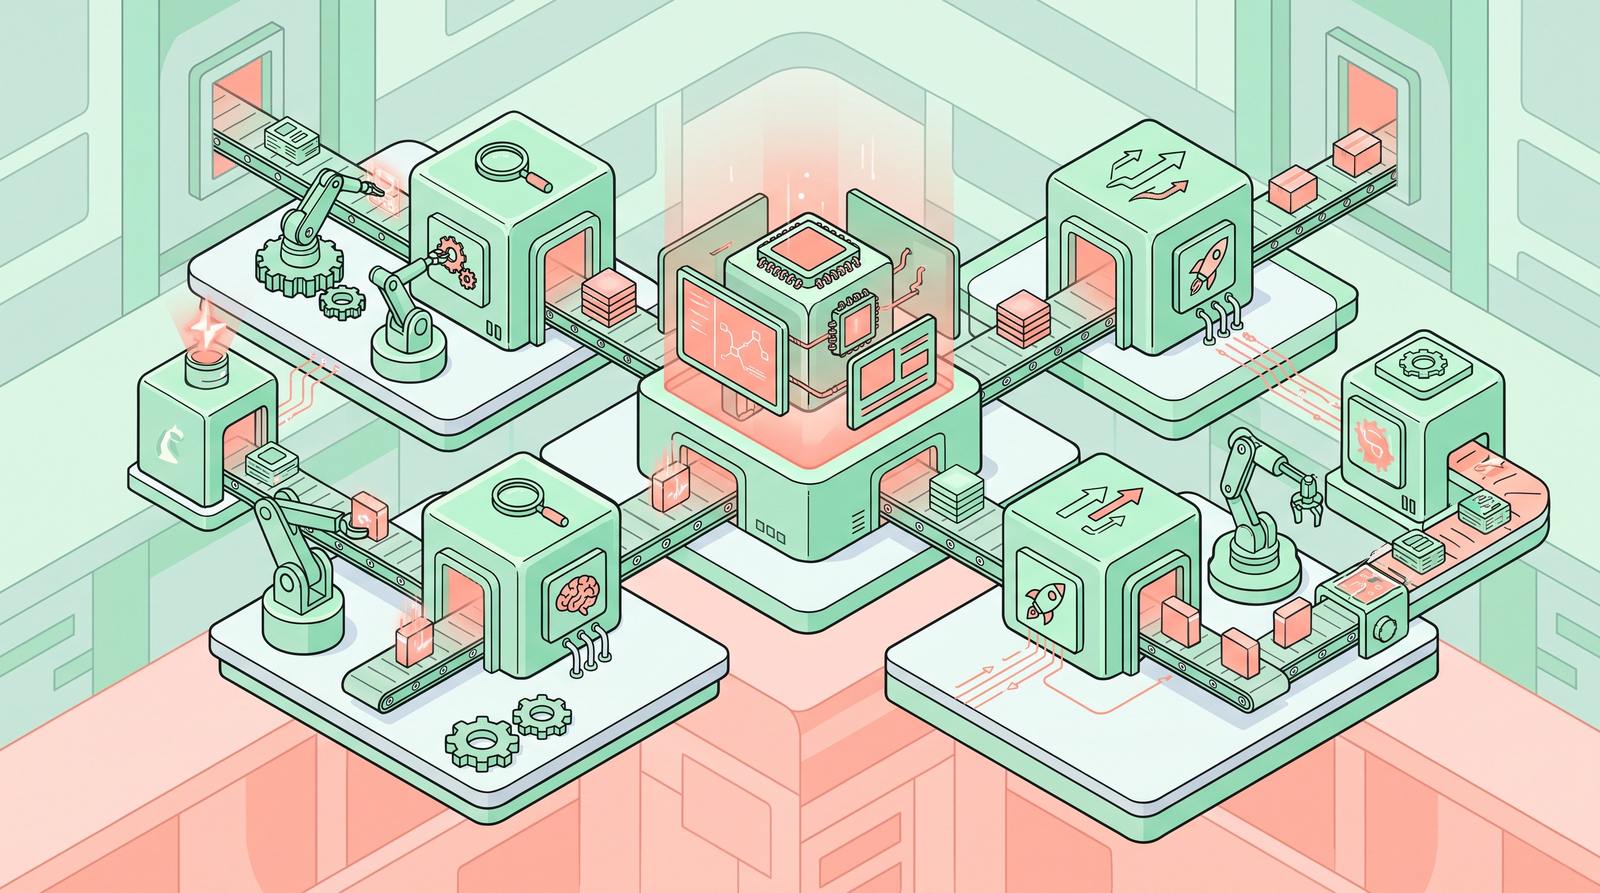
移动端 AI 阅读器是指部署于移动终端,利用自然语言处理与光学字符识别技术,实现文档智能解析、知识提取与交互式对话的软件系统。对于刚接触该领域的创作者而言,掌握大语言模型入门的核心逻辑,是理解工具能力边界的关键。该技术栈要求开发者平衡内存占用与算力调度。当前底层架构已形成三条清晰路线:
- 纯云端方案:依赖高强度API持续调用,解析速度受基站网络波动直接影响,优势在于能无缝接入千亿参数基座,适合处理长篇PDF与科研论文。
- 端云混合方案:OCR引擎与基础排版算法在手机NPU上本地运行,深度语义推理与跨文档关联任务上传云端服务器,有效平衡延迟与计算成本。
- 全离线方案:采用INT4量化的边缘小模型,彻底脱离互联网环境运行,保障了极端场景下的可用性,但长上下文窗口通常在8K tokens以内。
移动端 AI 阅读器排行:多维度横向对比
评测不同产品时,必须建立标准化测试基准。正如行业评估内容生成质量常参考《国内主流AI绘画模型出图色彩还原度实测对比》的严谨指标,阅读器的选型同样依赖可量化的性能参数。以下为三款标杆产品的实测数据拆解:
- 解析准确率:A产品在复杂学术版式下保持98.5%的文字还原率,B产品对多栏表格提取存在12%的结构错位,C产品针对漫画分镜与手写批注做了专项优化。
- 响应延迟:A产品平均首字生成耗时1.2秒,得益于请求队列调度优化;B产品因未做并发拦截机制,峰值并发达3.5秒;C产品依靠端侧推理,稳定维持在0.8秒。
- 记忆与上下文:A支持动态切片技术,理论上可处理无限长文本;B限制在固定长度的向量数据库缓存;C主打本地文件系统挂载,适合私有数据的高精度检索。该架构有效降低了单句Token消耗,提升并发吞吐量。
综合得分显示,侧重跨国办公与资料汇总的用户倾向A类架构,注重即时批注、轻社交分享与低电量消耗的群体更偏好C类产品。单纯的功能堆砌已无法形成技术壁垒,垂直领域的高质量语料清洗能力成为产品拉开差距的分水岭。
移动端 AI 阅读器排行:商业化路径与市场趋势
资本市场的资金流向直接映射产品的定价策略与运营重心。当前排行榜前列的应用普遍放弃一次性买断制,全面转向SaaS订阅模式。其营收结构呈现高度标准化的特征:
- 流量漏斗转化:基础解析功能保持免费以获取海量日活,通过广告激励与会员去重获取初始现金流,行业平均获客成本已压缩至单用户15元以内。
- 分层权益设计:标准版提供每日50次高级摘要与基础标注,专业版解锁无限次API调用、批量格式转换与企业级团队协作空间,月费定价集中在29至69元区间。
- ToB接口授权:将底层解析SDK封装后,向出版社、金融机构法务部与在线教育平台出售企业账号,按实际调用量阶梯计费,形成高毛利且稳定的基本盘。该模式依赖稳定的CDN节点支撑,确保全球用户访问一致性。
随着国产移动芯片算力持续提升与端侧大模型落地,未来两年将出现更多“硬件预装+软件服务”的生态捆绑策略。开发商需提前布局第三方插件市场,通过开放API延长用户生命周期,规避单一工具的替代品风险。
移动端 AI 阅读器排行:新手选择建议
面对繁杂的产品矩阵,初学者应遵循“需求导向、成本控制、数据安全”三步法进行筛选。具体决策流程与验证步骤如下:
- 明确核心诉求:若主要处理外文文献,优先选择内置专业术语库与多语种并行翻译的引擎;若侧重教材笔记整理,则重点关注本地标签管理系统与思维导图一键导出功能。
- 试用期压力测试:利用官方提供的7天体验卡,输入典型工作文档进行排版还原度测试。重点观察数学公式渲染、页眉脚注衔接与图片说明是否发生断裂或乱码。
- 评估隐性迁移成本:仔细检查导出格式是否被锁死自有封闭生态,避免日后数据迁移遭遇格式不兼容障碍。定期审查隐私条款,确认语音与文字数据是否默认勾选用于模型公开微调训练。
- 验证辅助模块:部分应用已引入RAG检索增强模块,大幅提升专业领域回答准确度,建议优先测试该功能在垂直知识库中的召回命中率。
建议新人从单点高频功能切入,逐步积累结构化提示词编写经验。当日常工具链完全熟练后,再根据团队规模与数据敏感度,评估是否升级至企业级私有化版本,此举可大幅降低前期试错损耗。
常见问题
免费版的解析精度为何会明显下降?
免费版限流且调用基础模型,系统为降成本自动降级队列,致排版截断。建议缩短单次输入长度,或选夜间低峰期使用。
如何有效防止个人敏感文档泄露?
上传前开启“不留存记录”。涉密文件用本地离线版或沙箱脱敏。定期查授权设备,强制踢出陌生登录节点。
结语
榜单迭代只是表层现象,底层的技术收敛、算力分发优化与商业模式重构才是产业演进的主线。读者只需紧扣自身实际工作流痛点,理性对照各项硬指标,即可快速构建高效、安全的数字化知识管理闭环。

王工
暂无介绍....


评论(0):