
RAG商业化路径探索:如何重构企业知识资产与服务链
RAG商业化落地的核心破局点》
RAG商业化路径的核心在于将非结构化数据转化为高可用向量库,通过精准检索降低幻觉成本,直接打通企业知识调用与服务交付闭环。
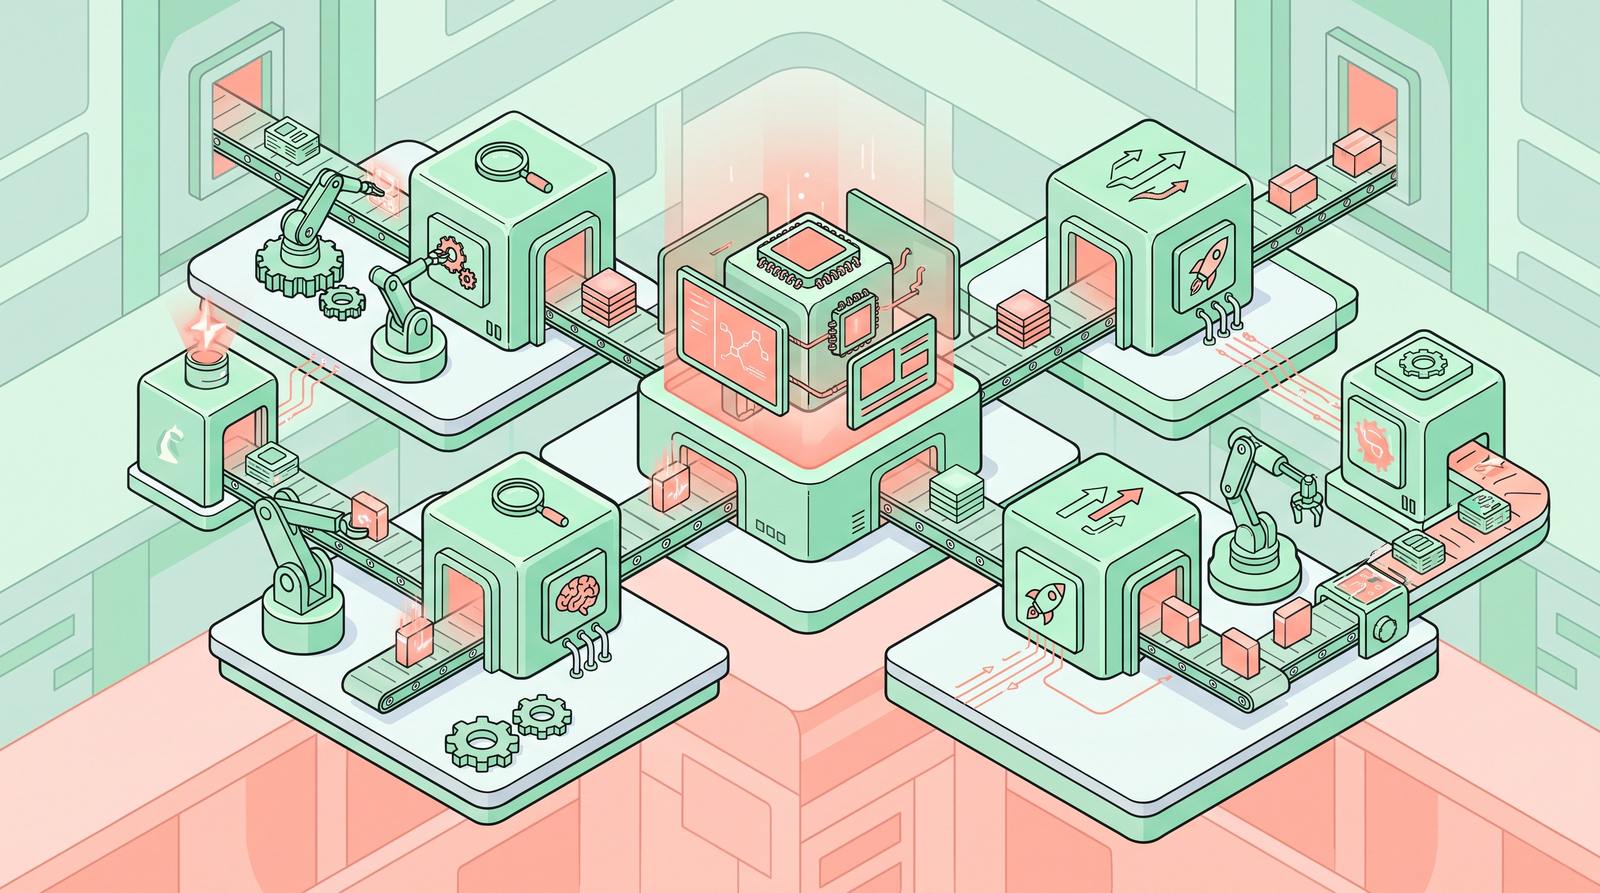
RAG(检索增强生成)是指在大模型推理前,先从外部知识库中召回相关片段并注入提示词,以事实依据约束生成结果的技术架构。它正从实验室原型快速走向产业纵深,成为重构企业数字资产的基础设施。面对高昂的算力与延迟瓶颈,一线团队需按以下清单推进商业化部署:
- 明确检索精度基线:放弃通用Embedding模型,针对垂直领域微调向量 encoder,将 Top-3 召回准确率稳定在 85% 以上,这是后续任何 Agent 调用的前提。
- 构建动态知识管道:采用“流批一体” ingestion 流程,将业务系统的 API 接口、文档沉淀与日志流水实时切片,避免静态数据库导致的知识滞后。
- 设计混合检索架构:结合关键词匹配(BM25)与语义向量搜索,利用重排序模型(Cross-Encoder)对候选集打分,解决长尾查询中的语义漂移问题。
RAG知识资产治理与清洗策略》
商业化的真正阻力往往不在算法,而在脏数据。企业必须建立符合合规要求的数据处理标准,例如跨境平台规则变化时,可参考《跨境电商卖家规避 AI 生成描述平台违规限流的实操指南》,将其底层逻辑迁移至内部知识库的标签体系,确保模型输出符合行业监管红线。同时,不要陷入盲目追求复杂模型的误区,许多从业者习惯从机器学习入门阶段就尝试端到端训练,但 RAG 时代更强调零样本或少样本的检索对齐。以下是资产治理的关键动作:
- 实施分级元数据标注:为每篇文档添加来源系统、更新时间、权限等级与业务分类字段,便于后续按角色动态过滤返回内容。
- 推行增量更新机制:废弃全量重建模式,引入基于哈希值或时间戳的变更检测,实现知识库的分钟级热更新。
- 建立质量评估沙盒:构建涵盖相关性、忠实度与指令遵循度的自动化评测集,每次迭代前进行对比测试,量化检索效果提升。
RAG驱动的服务链重构路径》
单一问答已无法支撑 B 端付费意愿,RAG 必须嵌入工作流才能产生商业价值。我们将检索模块封装为标准 SDK,允许下游工具链无缝接入。一线团队在规划服务架构时,应重点考察以下集成维度:
- 工具调用路由层:将 RAG 作为“大脑”而非终端,检索结果直接映射到 SQL 查询、API 执行或工单流转接口,实现从信息获取到业务操作的一键转化。
- 多模态上下文融合:支持图片、PDF 表格与音频转写文本的统一向量化,打破格式壁垒,满足客服质检、合同审查等复杂场景。
- 记忆状态持久化:引入短期会话窗口与长期用户画像库,使检索范围随交互历史自动扩展,构建具备连续对话能力的私有助手。
RAG市场竞争格局与成本管控》
当前 RAG 市场呈现开源框架繁荣与专有云服务分化的双轨态势。HaaS 厂商竞相推出低代码编排后台,而自研团队则转向边缘侧部署以降低延迟。对于追求 ROI 的企业,建议遵循以下管控原则:
- 采用分层算力调度:常规检索走 CPU 集群与轻量向量库,高精度重排与长上下文任务触发 GPU 弹性扩容,平衡响应速度与基础设施支出。
- 拥抱标准化协议:优先对接 LangChain/LlamaIndex 生态组件,避免被单一云厂商锁定,保持技术栈的可移植性与议价能力。
- 聚焦高价值场景切入口:避开泛聊天竞争,率先在供应链寻源、法务合规审阅等痛点深、容错率低的领域打造标杆案例,带动整体采购规模。
常见问题
企业从零启动 RAG 项目需要多久能看见商业回报?
通常需 3 至 6 个月完成数据清洗、检索管线搭建与首轮业务嵌合。早期可通过内部客服或研发助手降本,验证准确率达标后向外输出 API 服务即可实现营收转化。
如何判断当前方案是否过度依赖大模型参数规模?
若检索命中率始终低于 70%,且延长上下文窗口仅带来微弱增益,说明向量索引质量或分块策略存在缺陷。此时应优先优化特征提取与重排序权重,而非盲目叠加模型参数量。

李工
暂无介绍....

评论(0):